感知器模型在量化交易中的实战探索
 量化炼金
在深度学习风靡全球的今天,我们往往倾向于追求层数更深,结构更复杂的模型。然而,溯本逐源,所有的复杂神经网络都源自一个最基础的构件 - 感知器(Perceptron)。作为机器学习中最经典的线性分类器,感知器被官方文档称为“最简单的神经网络”。
本文将深入探讨 Zorro 感知器模型的底层逻辑,并尝试将其应用于金融市场的结构预测,通过实战回测揭示其在复杂交易场景中的表现与局限性。
1. 感知器算法的底层逻辑
核心原理:线性超平面的分割
adviseLong(PERCEPTRON) 算法的核心任务是:寻找一个超平面,将样本点在线性空间中进行分割。在交易场景中,这意味着它试图在多维特征空间里画出一条“直线”,将未来可能盈利的交易与亏损的交易区分开。
其数学表达如下:
其中:
- 代表输入的市场特征(如波动率、动能等)
- 是训练过程中学习到的特征权重
- 是偏移量
如果特征的线性加权组合超过预设阈值,模型便判定当前市场环境“有利可图”;反之则视为“无利可图”。
单一神经元的二元分类
一个标准的感知器仅包含单一神经元,没有隐藏层。它的工作流程非常纯粹:输入 -> 加权求和 -> 激活函数(阈值判别) -> 输出。
算法本质上是先通过回归计算出一个连续的分数,再利用固定阈值进行“一刀切”,从而将问题简化为二元分类(如:+100 代表赢,-100 代表输)。
| |
2. 工程实现与输出解读
特征预处理
在量化实战中,感知器对数据的分布较为敏感。为了保证模型训练的稳定性,所有输入特征都必须缩放到 [-1, 1] 区间。这一步骤能有效避免因指标量级差异导致的权重失衡。
输出结果
感知器的预测输出范围通常在 [-100, 100] 之间,我们可以通过不同的配置来解读其含义:
常规模式
adviseLong(PERCEPTRON)- 正负号:代表预测方向(正值代表正例,负值代表负例)。
- 绝对值:代表历史胜率。例如,输出为
+70,意味着基于历史训练数据,该特征组合下的预测准确率为 70%。
强度模式
adviseLong(PERCEPTRON+FUZZY)- 数值含义:不再是单纯的胜率,而是预测强度。
- 数值越大,属于正例(如上涨)的可能性越高;数值越小(越负),属于负例的可能性越高。
如何处理多元分类
感知器只能解决二元分类问题。如果我们需要预测更复杂的市场结构(如:上涨、下跌、震荡三态),则必须将问题拆解。
案例:预测三态市场结构
- 多头模型:将“上涨”设为 +1,“震荡和下跌”统称为 -1。使用
adviseLong(PERCEPTRON)训练。 - 空头模型:将“下跌”设为 +1,“上涨和震荡”统称为 -1。使用
adviseShort(PERCEPTRON)训练。
3. 构建交易策略
为了验证感知器的实操效果,我们构建了一个包含 5 个维度的特征矩阵,旨在从波动率、趋势、市场状态等多个维度捕捉市场信号。
| 指标 | 类型 | 公式 |
|---|---|---|
| AtrRatio | 波动率 | ATR(20)/ATR(100) |
| Distance2Trend | 趋势 | Price/Lowpass(Price,300) - 1 |
| FractalDimension | 市场状态 | FractalDimension(Price,50) |
| MACDHistogram | 动能加速度 | MACD(12,26,9) |
| AroonOscillator | 市场微观结构 | AroonOsc(300) |
我们将目标变量设定为“未来一天的市场结构”,并分别训练多头和空头两个感知器模型。
策略源代码:
| |
4. 回测结果分析
训练阶段表现
我们采用向前滚动验证(Walk-Forward Optimization, WFO)对模型进行训练,得到的各周期分类准确率如下。从数据上看,模型在训练集上尚有一定的识别能力(部分周期达到 60%-70%):
| |
样本外预测
感知器在样本外预测的表现令人失望。下图展示了预测结果:
- 子图 1:当前 K 线的市场实际状态(+1 为涨,0 为震荡,-1 为跌)。
- 子图 2:两个感知器模型的预测输出(绿色代表多头模型,红色代表空头模型)。
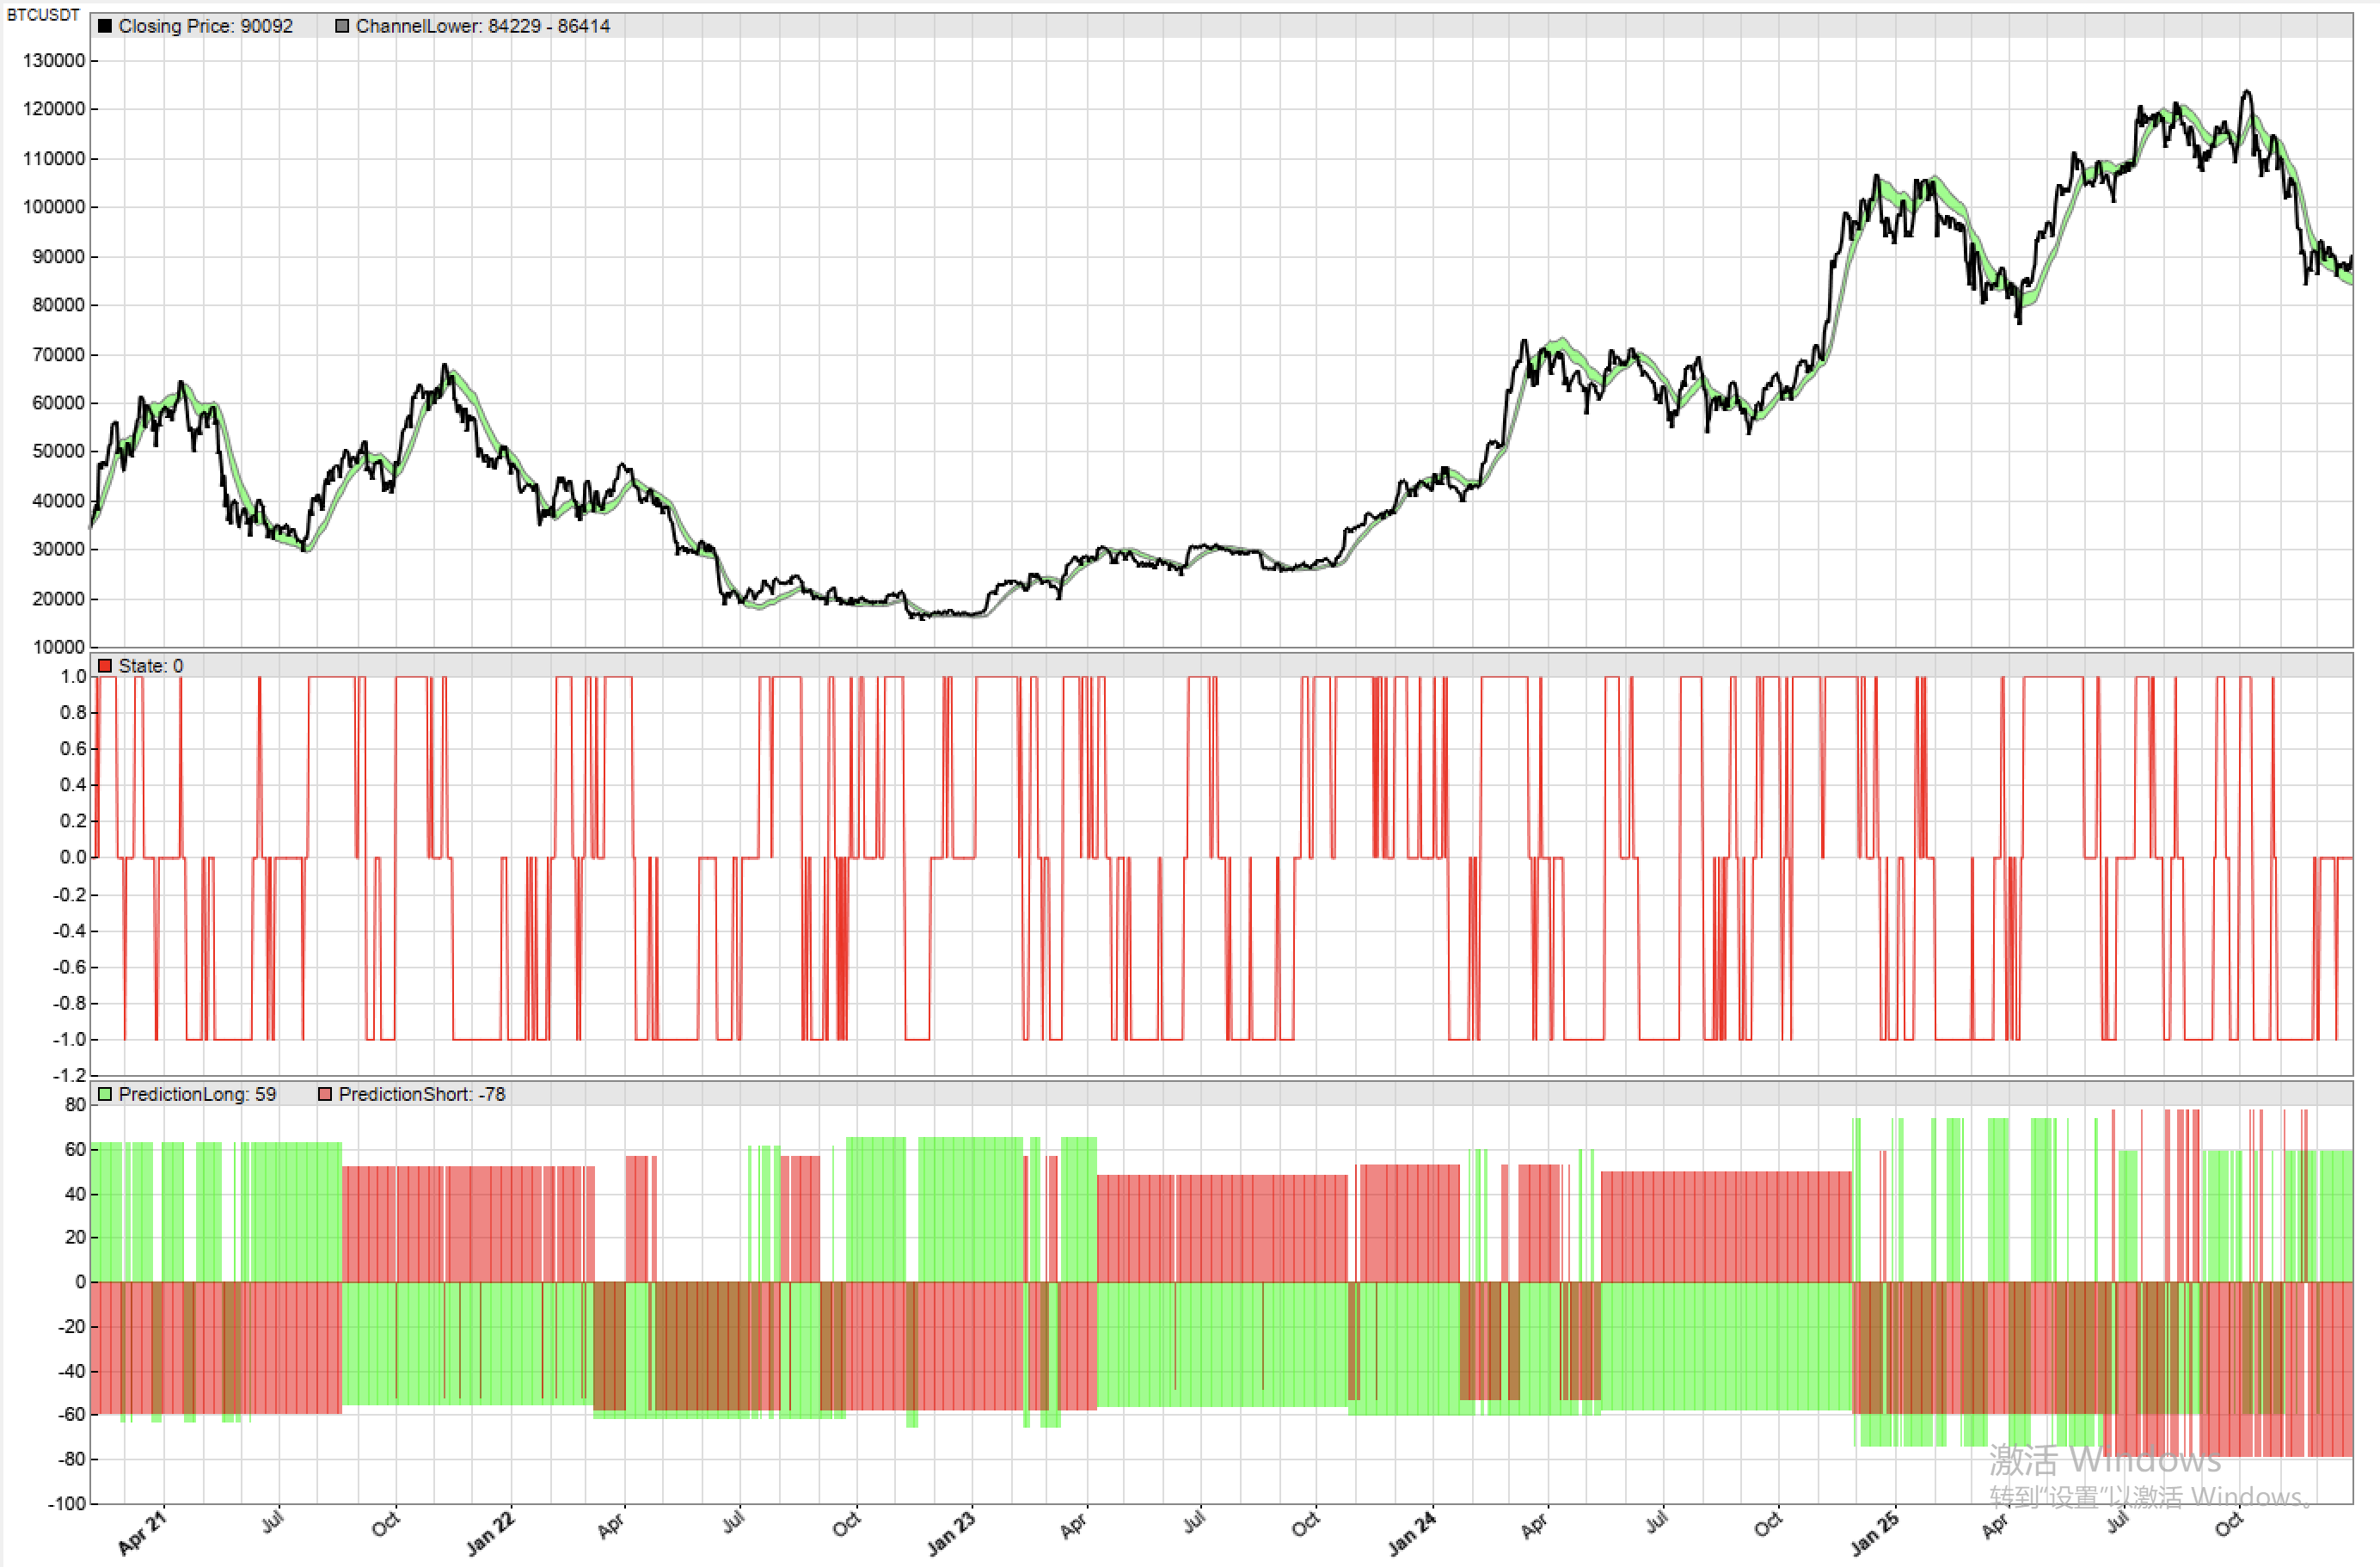
观察回测曲线可以发现,感知器对趋势的识别极其迟钝。在 2023 年第四季度至 2024 年第一季度期间,市场正处于强劲的单边牛市中,但多头模型的输出却持续低于 0(判定为负例,即市场处于下跌或震荡),而空头模型的预测反而持续大于 0(判定为正例,即市场处于下跌)。这种反向预测在实际交易中将导致灾难性的后果。
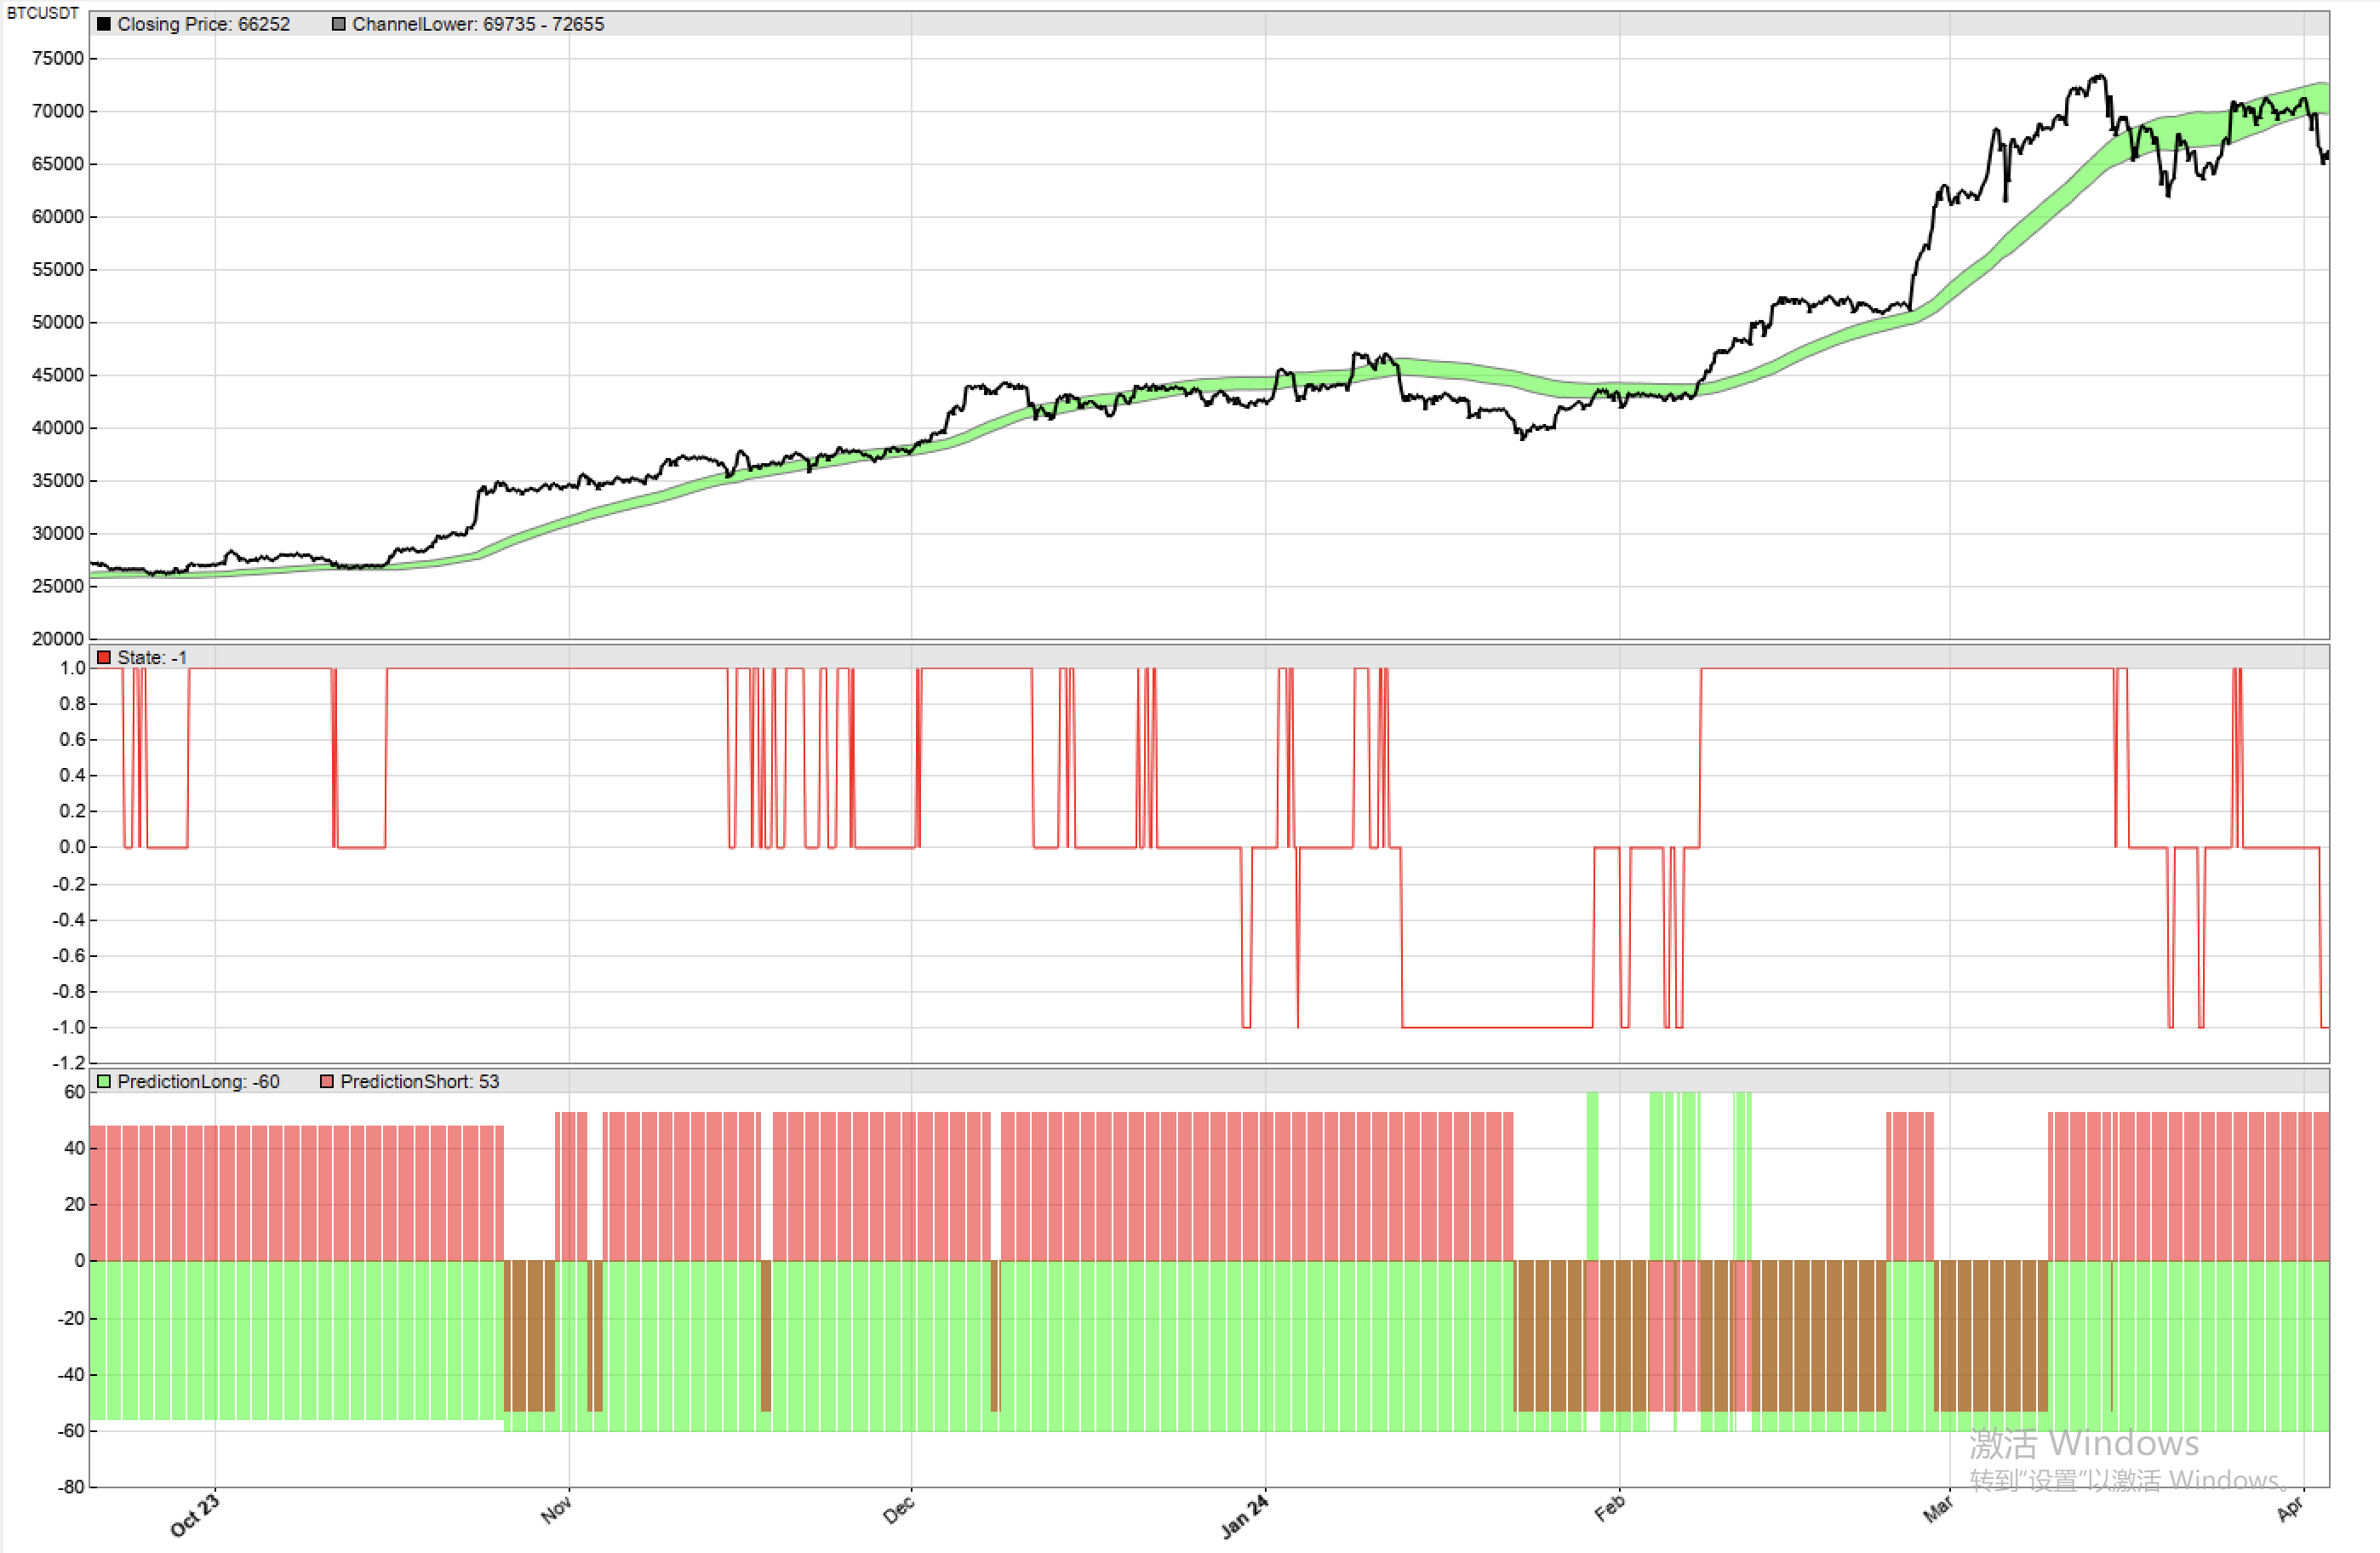
引入预测强度(FUZZY)
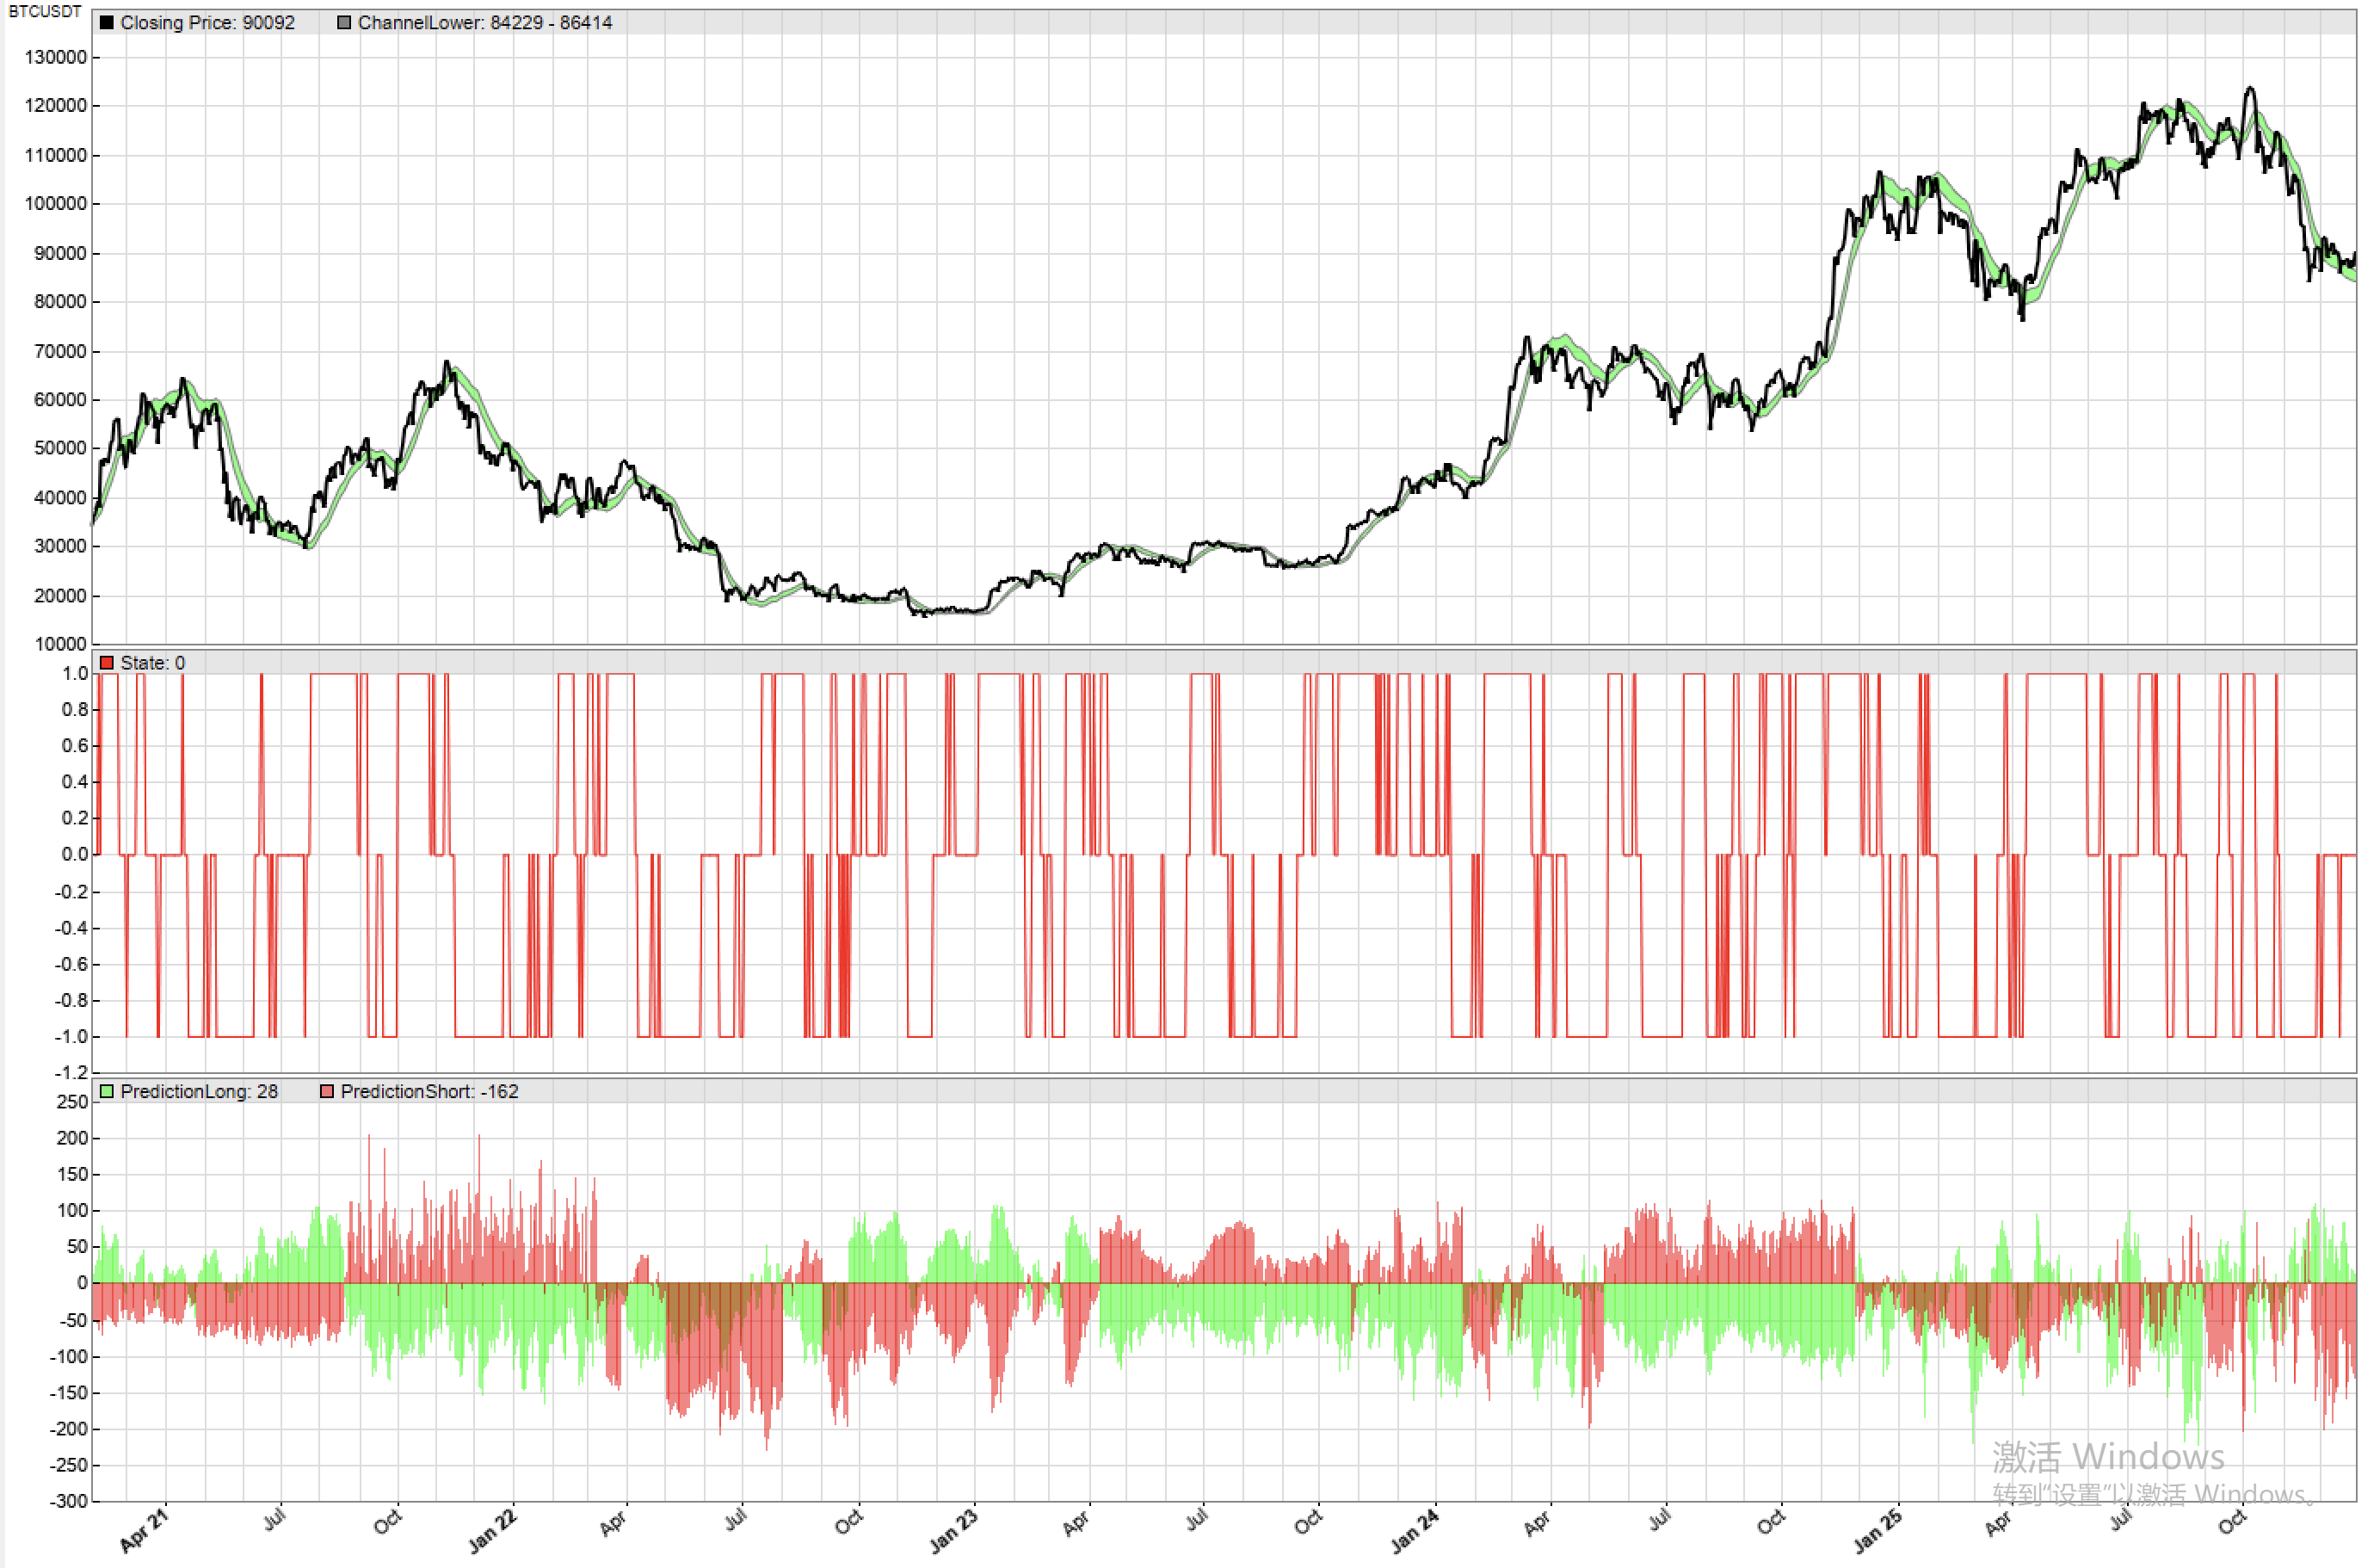
即使引入 +FUZZY 参数来获取更精细的“预测强度”,结果依然没有改观。模型依然无法捕捉到最明显的趋势反转或持续特征。
5. 总结
通过对感知器模型的探索研究,我们可以总结出其表现糟糕的几个潜在原因:
市场的结构性变异:量化模型面临的最大敌人是“分布漂移”。如果训练集主要是震荡市或熊市数据,而测试集进入了牛市,感知器这种简单的线性模型很难在瞬息万变的分布转换中保持鲁棒性。
线性模型的局限性:感知器只能处理线性可分的问题。然而,金融市场的特征与收益率之间往往存在复杂的非线性关系。如果盈利样本与亏损样本在特征空间中是以非线性方式交织的,感知器永远无法找到那条能有效切分的“直线”。
特征预测能力不足:目前的特征(波动率、MACD 等)可能并未包含足够的预测信息,或者感知器这种结构无法有效提取这些信息。
思考与改进
对比我们之前进行的决策树模型测试,在相同的特征和目标变量下,决策树的表现显著优于感知器。这进一步印证了金融数据中非线性逻辑的重要性。
感知器虽然是神经网络的起源,但在充满噪声和非线性的量化金融领域,它更适合作为一个基线模型,而非独立作战的决策工具。