在前三部分的研究中,我们完成了特征工程、数据稳定化检验,并通过贝叶斯信息准则(BIC)确定了最优的隐状态数量为5个。
使用隐马尔可夫模型(HMM)识别市场结构:第一部分
使用隐马尔可夫模型(HMM)识别市场结构:第二部分
使用隐马尔可夫模型(HMM)识别市场结构:第三部分
本部分是核心应用的起始点:我们将使用最优参数(5个状态)来训练最终的HMM模型,并进行状态语义解读。HMM模型输出的0-4数字编号并没有直接的金融意义,需要我们根据每个状态的特征均值,赋予其明确的“市场结构”标签(例如:牛市趋势、宽幅震荡等)。最后,我们将进行初步的样本外预测,直观验证模型的有效性。
模型训练与状态均值提取
首先,我们导入必要的库,并使用交互式界面选择训练数据。
代码准备与模型训练
我们沿用之前定义的 train_hmm 函数,并将其状态数固定为5。
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
| import marimo as mo
from pathlib import Path
import numpy as np
import pandas as pd
import plotly.graph_objects as go
import plotly.express as px
import plotly.io as pio
from sklearn.preprocessing import StandardScaler
from hmmlearn import hmm
pio.templates.default = "simple_white"
data_dir = Path("data/")
|
选择训练集文件:
1
2
3
4
| file_selector = mo.ui.file(
filetypes=[".csv"], kind="area", label="Select training file"
)
file_selector
|
加载数据并训练5状态HMM模型:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
| mo.stop(not file_selector.value)
def train_hmm(
features: pd.DataFrame,
states: int = 3,
random_state: int = 123,
verbose: bool = False,
) -> tuple[hmm.GaussianHMM, StandardScaler]:
"""训练隐马尔可夫模型"""
# 特征标准化
scaler = StandardScaler()
features_scaled = scaler.fit_transform(features)
# 创建模型对象
model = hmm.GaussianHMM(
n_components=states,
covariance_type="full", # 特征相关程度高,应使用完全协方差矩阵,否则模型可能不收敛
n_iter=2000,
tol=1e-5,
random_state=random_state,
verbose=verbose,
)
# 训练模型
model.fit(features_scaled)
return model, scaler
# 准备特征
features_path = data_dir / Path(file_selector.value[0].name)
wfo_num = int(features_path.stem.split("_")[-1])
features = pd.read_csv(features_path, index_col="date", parse_dates=True)
# 训练模型
model, scaler = train_hmm(features, states=5)
|
状态语义解读
HMM模型的model.means_输出的是标准化后的特征均值,我们需要将其逆标准化回原始尺度,才能进行直观的金融解读。
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
| mo.stop(not file_selector.value)
# 解读状态均值
def get_state_means(
model: hmm.GaussianHMM, scaler: StandardScaler, feature_names: list[str]
) -> pd.DataFrame:
# model.means_ 是标准化后的均值,为了直观理解,我们需要将其“逆标准化”回原始尺度
original_means = scaler.inverse_transform(model.means_)
means_df = pd.DataFrame(original_means, columns=feature_names)
return means_df
state_means = get_state_means(model, scaler, list(features.columns))
state_means
|
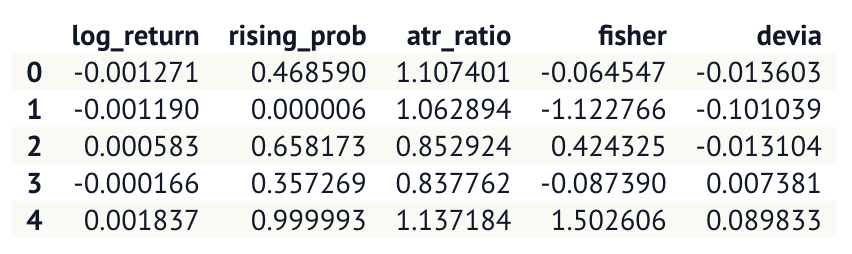
自动化状态命名规则
基于上述逆标准化后的状态均值表,我们可以清晰地定义5个状态的经济意义。这里的核心原理是利用特征指标的极端值和相对值来区分市场行为。
状态解读与分类
| HMM State (示例) | log_ret (收益率) | rising_prob (上涨概率) | atr_ratio (波动率比) | devia (价格偏离) | 状态含义(我们的命名) |
|---|
| 状态A | > 0 (强正) | 接近 1.0 (高) | > 1.0 (高) | 显著 > 0 (高) | 上涨趋势 (bull_trend) |
| 状态B | < 0 (强负) | 接近 0 (低) | > 1.0 (高) | 显著 < 0 (低) | 下跌趋势 (bear_trend) |
| 状态C | 接近 0 | 0.5 - 1.0 | < 1.0 (低) | 接近 0 | 上涨动能不足 (bull_pause)(低波动率整理) |
| 状态D | 接近 0 | 0 - 0.5 | < 1.0 (低) | 接近 0 | 下跌动能不足 (bear_pause)(低波动率整理) |
| 状态E | 接近 0 | 接近 0.5 | > 1.0 (高) | 接近 0 | 高波动震荡 (high_vol_chop)(趋势不明) |
辅助函数:基于特征均值自动映射状态
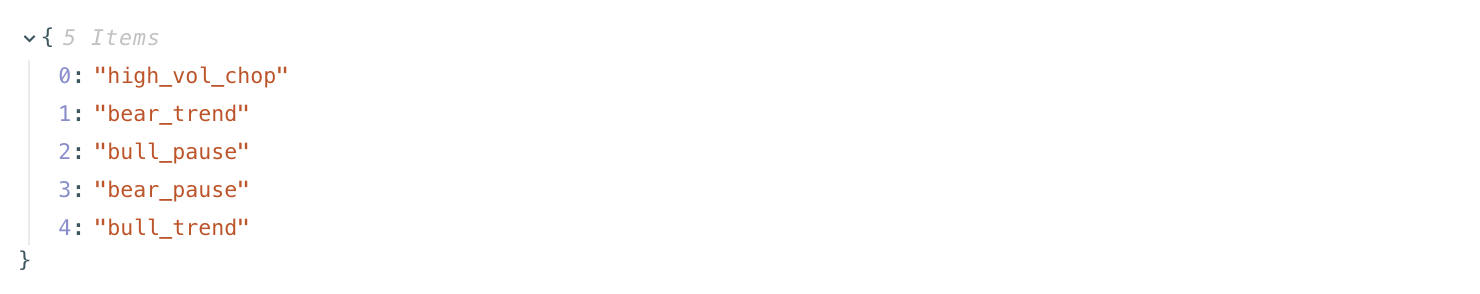
为了在多轮WFO中保持状态命名的一致性(因为HMM每次训练分配的ID 0-4可能是随机的),我们建立了一个基于状态特征排序的自动化规则。
规则核心:
- 找到
rising_prob最大和最小的状态,定义为bull_trend和bear_trend。 - 在剩下的三个状态中,找到
atr_ratio最高的,定义为高波动震荡(high_vol_chop)。 - 剩下的两个低波动状态,根据
rising_prob的高低,分别命名为bull_pause和bear_pause。
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
| mo.stop(not file_selector.value)
# 自动识别状态
def map_states_to_labels(
model: hmm.GaussianHMM, scaler: StandardScaler, feature_names: list[str]
) -> dict[int, str]:
"""
自动将HMM的状态ID映射到预定义的标签。
该函数的核心是基于每个状态的特征均值来识别其市场意义。
"""
# 获取状态均值
state_means = get_state_means(model, scaler, feature_names)
# 按照 rising_prob 对状态进行排序
sorted_states = state_means["rising_prob"].sort_values().index
# 识别两端的最强趋势
bear_trend_id = sorted_states[0] # rising_prob 最小
bull_trend_id = sorted_states[-1] # rising_prob 最大
# 在剩余的状态中,根据atr_ratio区分 "Pause" 和 "Chop"
remaining_ids = sorted_states[1:-1]
remaining_means = state_means.loc[remaining_ids]
remaining_means
# 找到波动性最高/最低的那个
high_vol_chop_id = remaining_means["atr_ratio"].idxmax()
low_vol_id1 = remaining_means[
"atr_ratio"
].idxmin() # 可能是 Bull_Pause 或 Bear_Pause
# 剩余的最后一个
remaining_ids_set = set(remaining_ids) - {high_vol_chop_id, low_vol_id1}
low_vol_id2 = list(remaining_ids_set)[0]
# 根据 low_vol_id1和id2的 rising_prob 来确定哪个是 Bull_Pause, 哪个是 Bear_Pause
if (
state_means.loc[low_vol_id1, "rising_prob"]
> state_means.loc[low_vol_id2, "rising_prob"]
):
bull_pause_id = low_vol_id1
bear_pause_id = low_vol_id2
else:
bull_pause_id = low_vol_id2
bear_pause_id = low_vol_id1
# 构建映射
state_mapping = {
bull_trend_id: "bull_trend",
bear_trend_id: "bear_trend",
bull_pause_id: "bull_pause",
bear_pause_id: "bear_pause",
high_vol_chop_id: "high_vol_chop",
}
return state_mapping
state_labels = map_states_to_labels(model, scaler, list(features.columns))
state_labels
|
样本外预测与可视化验证
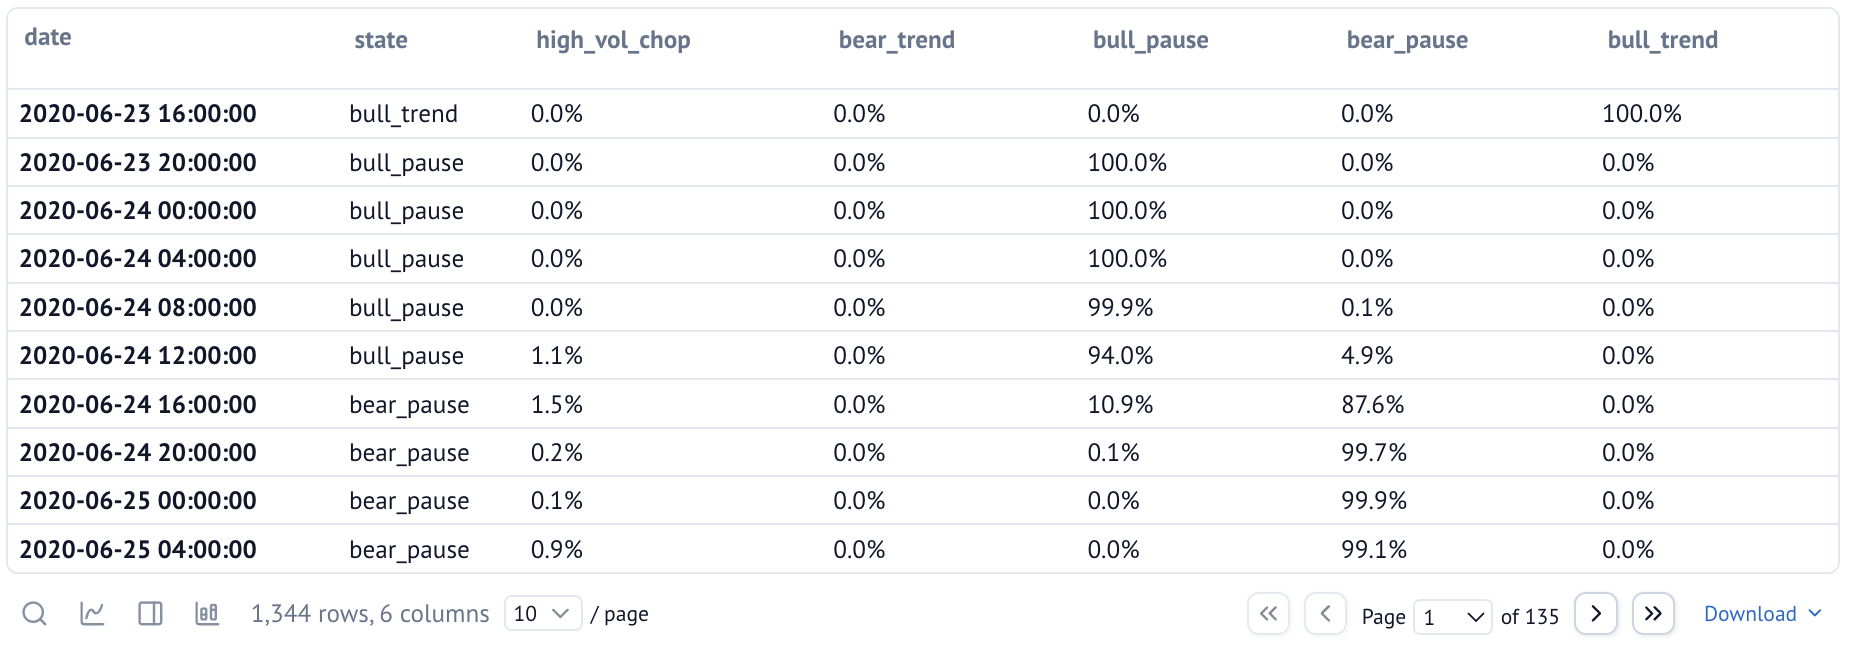
模型建立完成后,我们需要将它应用到WFO的样本外数据(测试集)上,预测每一时刻市场最有可能处于哪个状态。
预测函数实现
predict_state 函数将输入特征标准化后,调用HMM模型的 predict(预测最可能的状态)和 predict_proba(预测每个状态的概率)。
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
| mo.stop(not file_selector.value)
def predict_state(
model: hmm.GaussianHMM,
scaler: StandardScaler,
latest_features_df: pd.DataFrame,
labels: dict[int, str],
) -> pd.DataFrame:
"""
输入训练好的模型、scaler和包含最新特征的DataFrame,预测潜状态。
"""
# 对新数据进行标准化(不需要fit)
features_scaled = scaler.transform(latest_features_df)
# 预测状态
states = model.predict(features_scaled)
states_series = pd.Series(states, index=latest_features_df.index)
states_series.name = "state"
states_series = states_series.map(labels)
# 预测状态概率
state_probs = model.predict_proba(features_scaled)
state_probs_df = pd.DataFrame(
state_probs,
index=latest_features_df.index,
columns=list(range(model.n_components)),
)
state_probs_df.columns = state_probs_df.columns.map(labels)
return pd.concat([states_series, state_probs_df], axis=1)
# 获取样本外数据
oos_prices = pd.read_csv(
data_dir / "BTCUSDT_oos_prices.csv", index_col="date", parse_dates=True
)
oos_prices = oos_prices.query("wfo == @wfo_num")
# 样本外预测
oos_features = oos_prices[
["log_return", "rising_prob", "atr_ratio", "fisher", "devia"]
]
labels = map_states_to_labels(model, scaler, oos_features.columns)
predicted_states = predict_state(model, scaler, oos_features, labels)
mo.ui.table(
predicted_states,
selection=None,
show_column_summaries=False,
show_data_types=False,
format_mapping={
"bull_trend": "{:.1%}",
"bear_trend": "{:.1%}",
"bull_pause": "{:.1%}",
"bear_pause": "{:.1%}",
"high_vol_chop": "{:.1%}",
},
)
|
市场状态可视化
为了直观检验HMM的识别效果,我们将预测出的五种市场状态叠加到价格走势图的背景上。
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
| mo.stop(not file_selector.value)
# 创建价格图表
fig = px.line(x=oos_prices.index, y=oos_prices["price"])
# 定义5种市场状态对应的颜色
state_colors = {
"bull_trend": "rgba(34, 139, 34, 0.7)", # 深绿色 - 强势上涨
"bear_trend": "rgba(220, 20, 60, 0.7)", # 深红色 - 强势下跌
"bull_pause": "rgba(144, 238, 144, 0.5)", # 浅绿色 - 上涨暂停/整理
"bear_pause": "rgba(255, 182, 193, 0.5)", # 浅红色 - 下跌暂停/整理
"high_vol_chop": "rgba(65, 105, 225, 0.5)", # 蓝色 - 高波动震荡
}
# 获取状态序列
states = predicted_states["state"]
# 识别连续相同状态的区间
current_state = None
start_idx = None
for i, (date, state) in enumerate(states.items()):
if state != current_state:
# 如果不是第一个状态,先为前一个状态区间添加背景
if current_state is not None and start_idx is not None:
fig.add_vrect(
x0=states.index[start_idx],
x1=date,
fillcolor=state_colors[current_state],
layer="below",
line_width=0,
)
# 开始新的状态区间
current_state = state
start_idx = i
# 处理最后一个状态区间
if current_state is not None and start_idx is not None:
fig.add_vrect(
x0=states.index[start_idx],
x1=states.index[-1],
fillcolor=state_colors[current_state],
layer="below",
line_width=0,
)
# 更新布局
fig.update_layout(
title="Predicted Market Regime",
width=1000,
height=600,
xaxis_rangeslider_visible=False,
hovermode="x unified",
yaxis_title="USDT",
)
fig
|
测试集1的样本外测试结果示例:
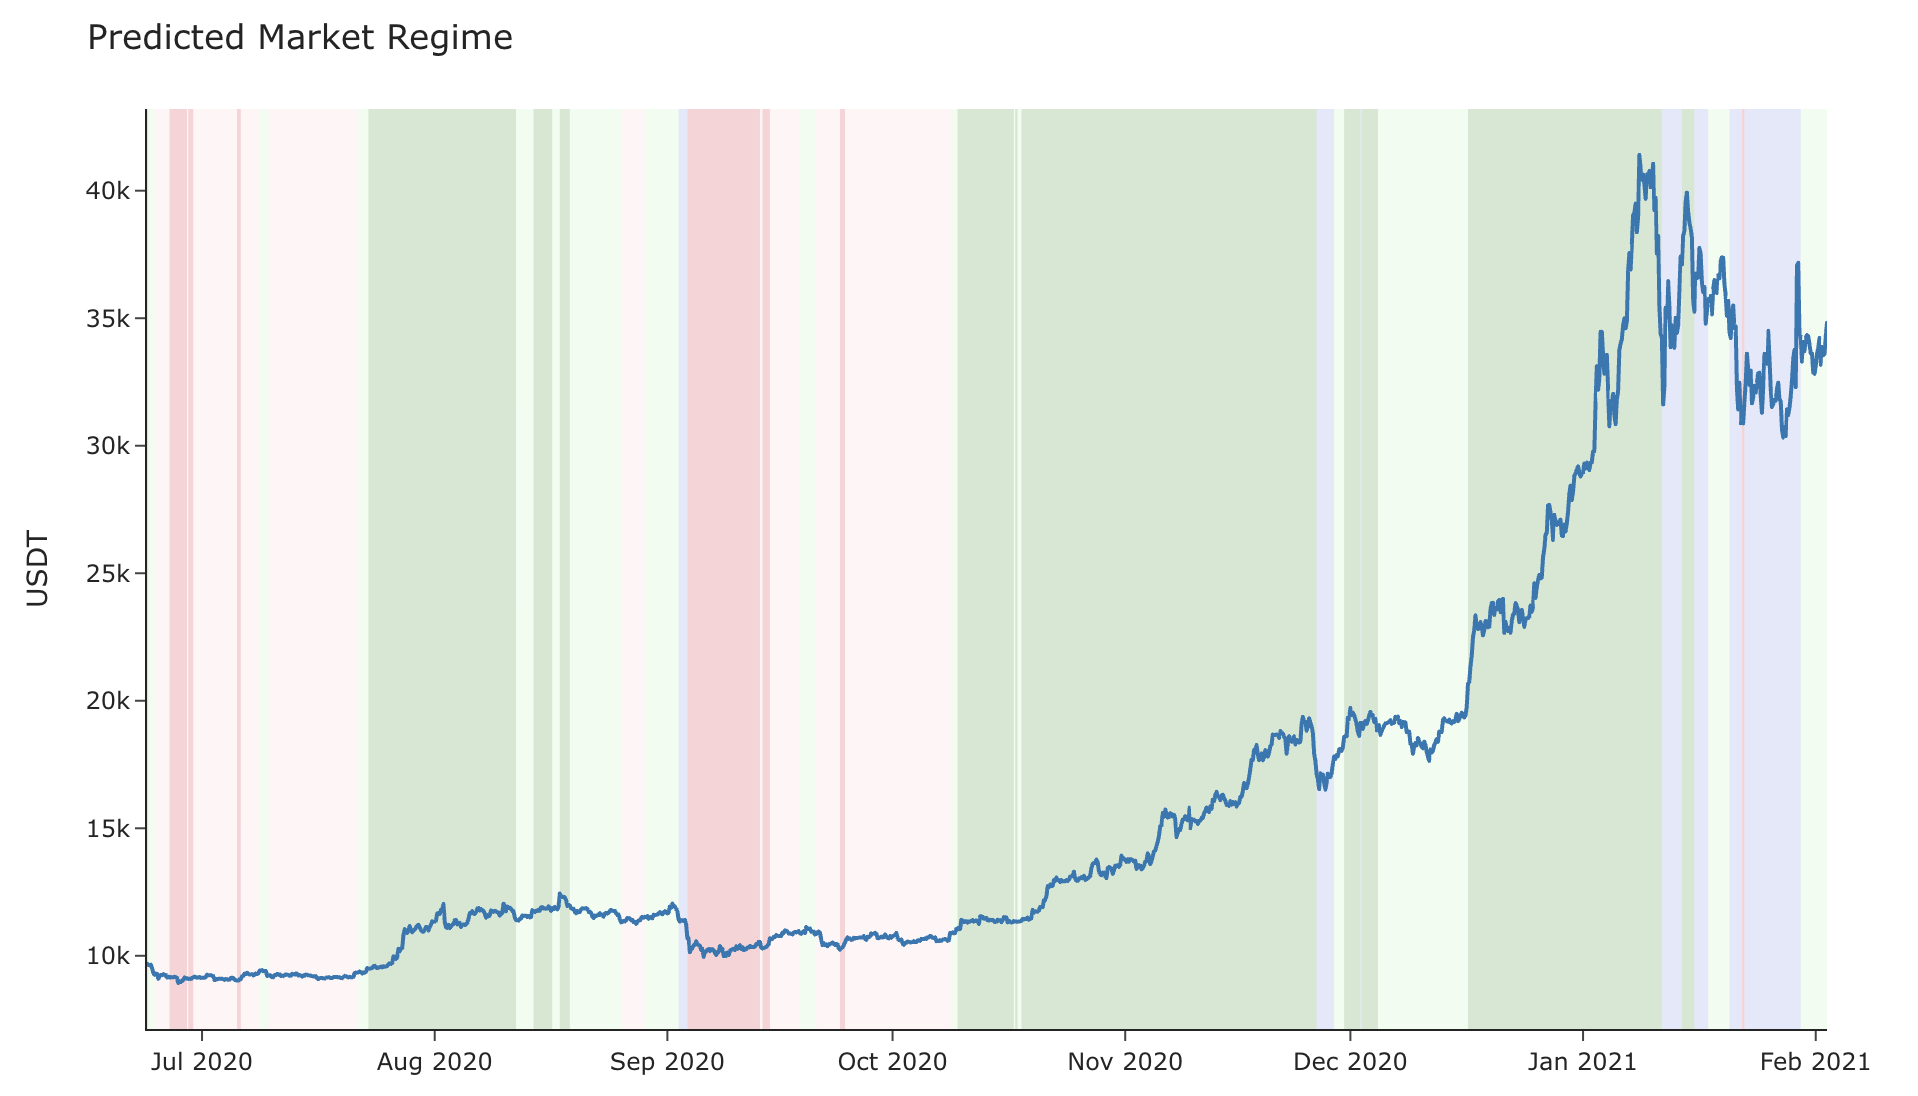
多轮测试集验证结果
| 训练集 | 测试集 | 结果图示 | 观察结论 |
|---|
| 训练集2 | 2021/02 - 2021/09 (牛市中期到顶部) | 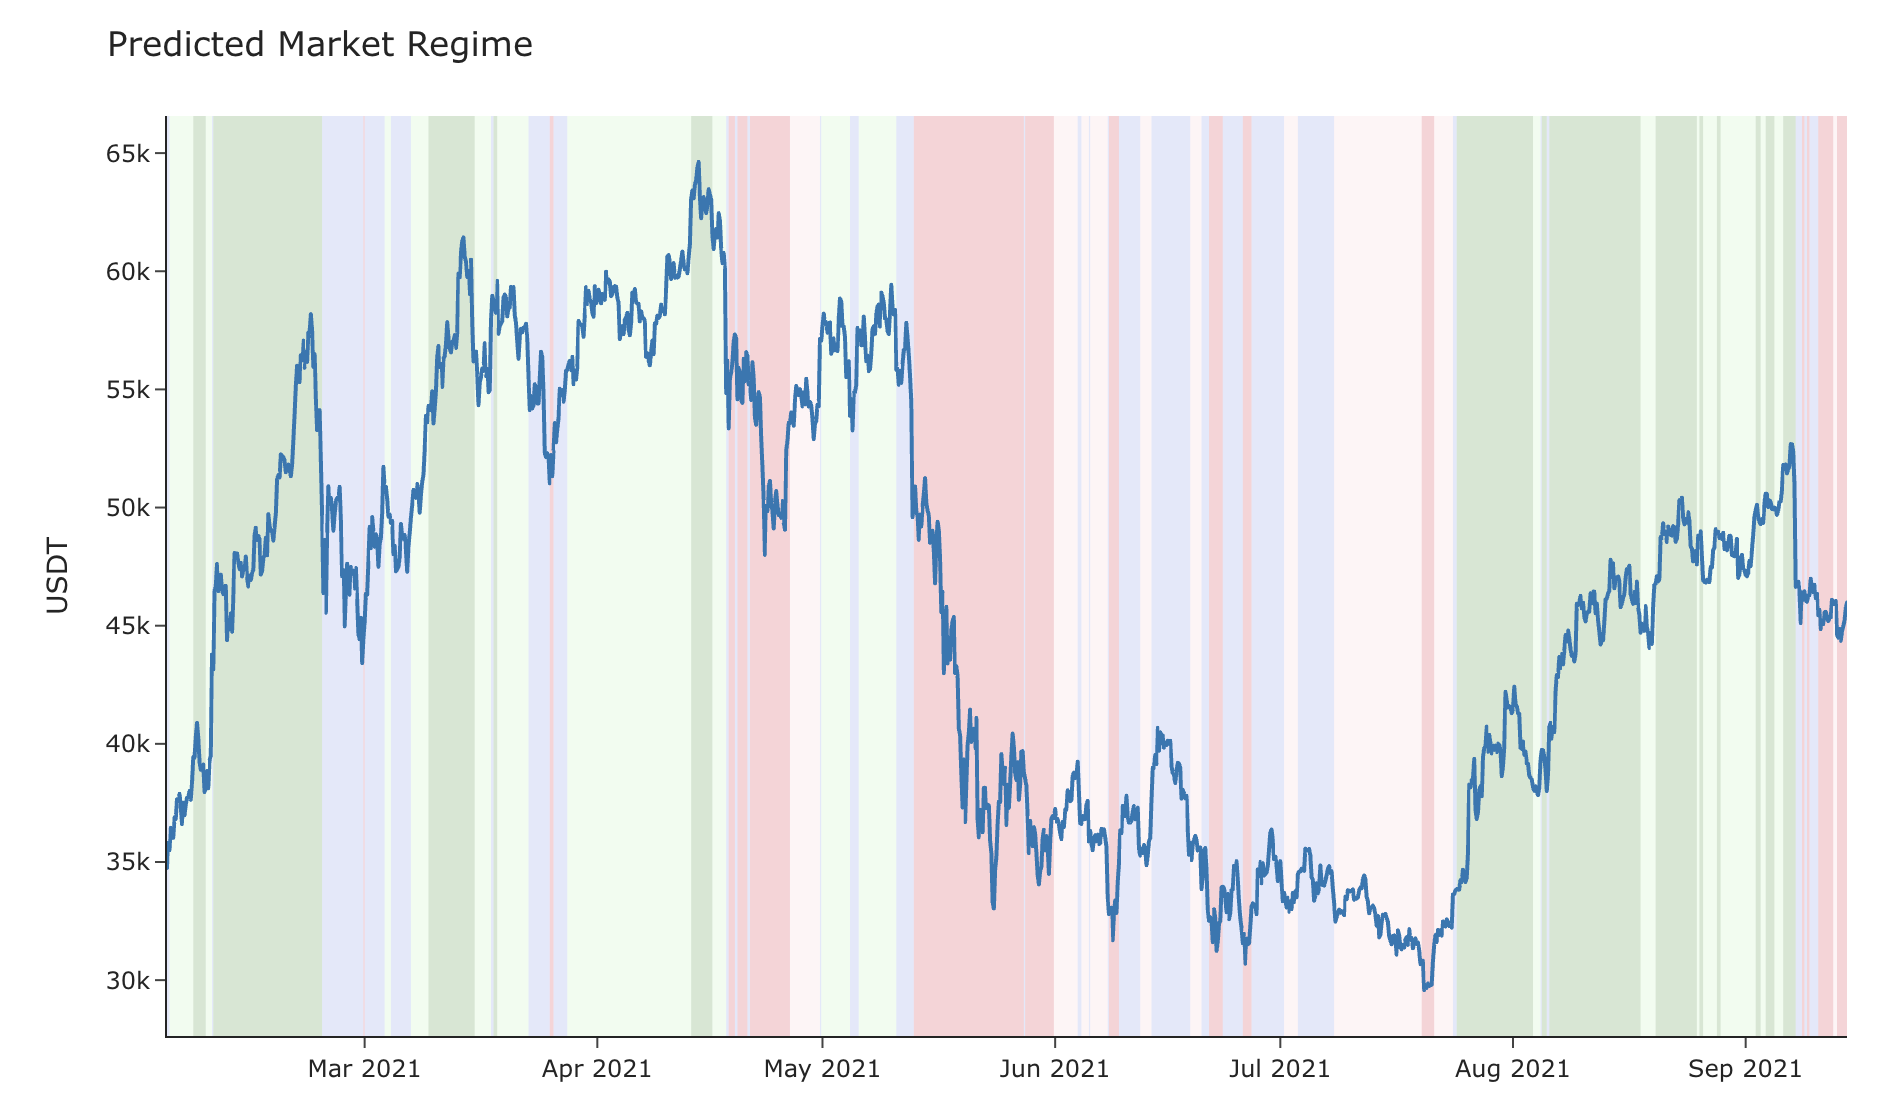 | 成功识别了大部分趋势,但在趋势中期的回调(如2021年5月大跌)能快速识别出bear_trend或bear_pause。 |
| 训练集5 | 2022/12 - 2023/07 | 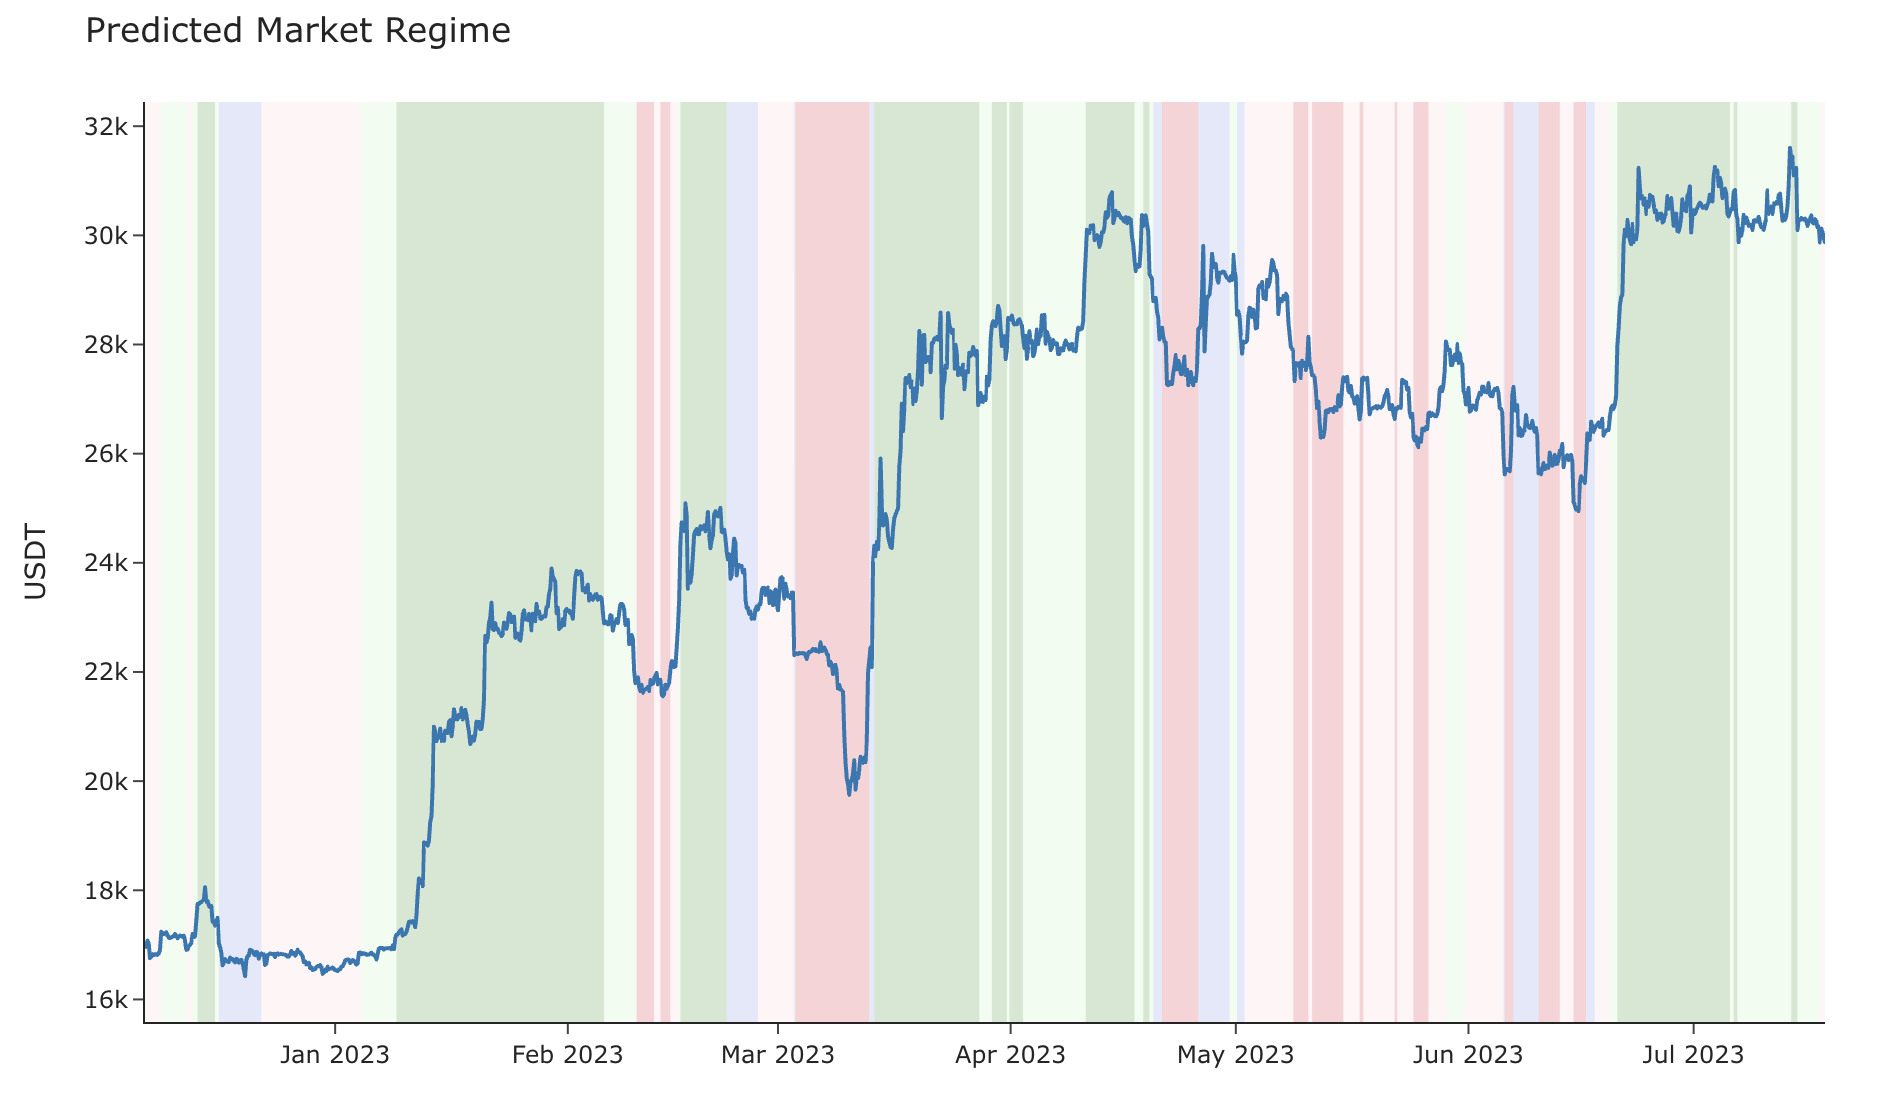 | 捕捉了初期市场的低波动整理(pause状态),并在2023年3月趋势启动时,迅速定位到bull_trend。 |
| 训练集7 | 2024/02 - 2024/10 | 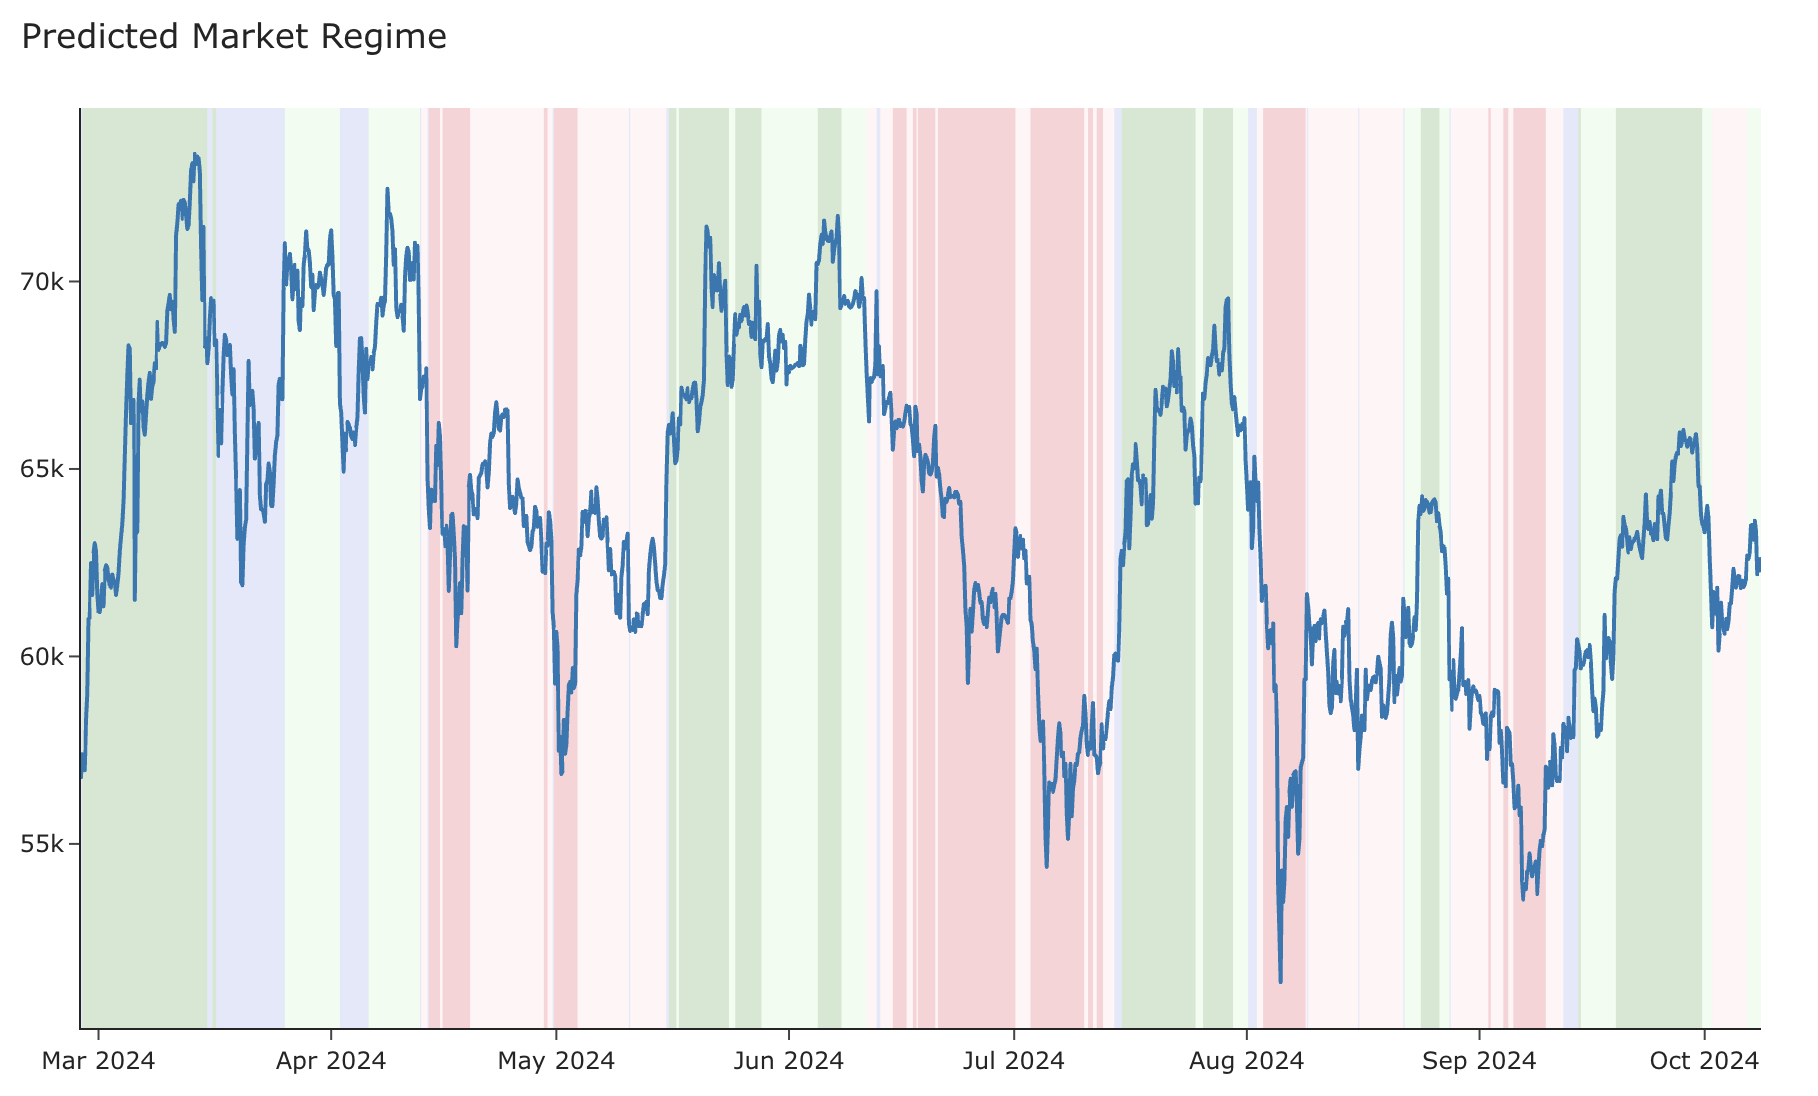 | 识别了2024年上半年的高位震荡,状态在各种pause和high_vol_chop之间频繁切换,符合市场实际的混沌结构。 |
总结分析
优点:
- 结构划分清晰:5状态模型能够相对准确地将市场划分为两种趋势、两种整理和一种高波动震荡,为构建多模式交易策略奠定了基础。
- 趋势识别准确:在出现持续数月的明确上涨或下跌行情时,HMM能够准确地识别出
bull_trend/bear_trend状态。
局限性(未来优化方向):
- 震荡区间的模糊性:在持续时间较长的横盘震荡行情中,市场状态在
bull_pause、bear_pause和high_vol_chop之间切换过于频繁,界限不够明确。 - 趋势反转延迟:HMM作为一个诊断模型,其状态切换通常依赖于多根K线形成趋势特征后才能确定,对趋势反转的识别(即状态的切换),反应仍然不够敏捷。
下一步:
- 将所有WFO测试集的预测状态和概率数据整合并保存到CSV文件。
- 将这些状态数据导入Zorro交易平台。
- 设计基于状态概率和状态标签的交易逻辑(例如:在
bull_trend时仅做多,在high_vol_chop时切换至均值回归),进行全面的回溯检验,以评估该HMM模型的最终价值。
 量化炼金