摘要:状态数的选择是HMM建模的关键
在前两部分,我们完成了特征工程、数据导出以及特征分布的稳定性检验。现在,我们进入HMM模型构建的核心步骤:确定隐状态(Hidden States)的最佳数量。
HMM的状态数是模型的核心超参数,它直接决定了模型对市场结构的划分粒度。状态数太少,可能导致模型无法捕捉到复杂的市场行为;状态数太多,则会引入过拟合的风险,使得模型难以泛化和解释。
本部分将系统性地探讨如何使用**贝叶斯信息准则(BIC)**作为模型选择的指南,通过多轮滚动训练(WFO)检验,确定一个既能有效拟合数据又具有良好稳定性和解释性的最佳状态数。
💡 模型选择标准:AIC vs. BIC
AIC(赤池信息准则) 和 BIC(贝叶斯信息准则) 都是衡量模型拟合优度的标准,用于在复杂性与拟合度之间进行权衡。
- BIC 对模型复杂度的惩罚比AIC更重。这意味着BIC倾向于选择更简单(参数更少)的模型,这对于时间序列模型尤为重要,因为它能有效帮助我们防止过拟合。因此,我们选用BIC作为选择最佳隐状态数的首要指标。
第一部分:设计科学的状态数选择实验
我们的研究方法旨在确保所选的状态数不仅在某一个训练集上表现最优,而是在多轮市场周期中都保持稳定。
研究方法论
- 多轮训练:对每一轮WFO训练集(In-Sample Data),分别使用从小到大不同数量的隐状态(例如3到8个)拟合HMM模型。
- 计算BIC:记录每种状态数配置下的BIC值。
- 分析稳定性与增益:
- 稳定性检验: 观察不同训练集中,BIC最低的状态数是否一致。如果结果一致,说明我们的特征集能够稳定地识别出特定数量的核心市场结构。如果结果不一致(最佳状态数在不同WFO周期中“反复横跳”),则说明特征工程可能存在缺陷。
- 增益分析: 计算BIC在状态数增加时的相对降幅(百分比变化)。当BIC的降幅显著变小时,意味着增加状态数带来的边际效益递减,存在过拟合风险。
代码准备:辅助函数和参数设置
我们将使用 hmmlearn 库中的 GaussianHMM 模型进行拟合。值得注意的是,由于我们使用的特征之间相关性较高,我们将covariance_type设置为"full",这允许模型捕捉特征间的协方差,从而提高模型的拟合准确性。
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
| import marimo as mo
from pathlib import Path
import numpy as np
import pandas as pd
from sklearn.preprocessing import StandardScaler
from hmmlearn import hmm
data_dir = Path("data/")
|
HMM训练辅助函数:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
| def train_hmm(
features: pd.DataFrame,
states: int = 3,
random_state: int = 123,
verbose: bool = False,
) -> tuple[hmm.GaussianHMM, StandardScaler]:
"""训练隐马尔可夫模型"""
# 特征标准化
scaler = StandardScaler()
features_scaled = scaler.fit_transform(features)
# 创建模型对象
model = hmm.GaussianHMM(
n_components=states,
covariance_type="full", # 特征相关程度高,应使用完全协方差矩阵,否则模型可能不收敛
n_iter=2000,
tol=1e-5,
random_state=random_state,
verbose=verbose,
)
# 训练模型
model.fit(features_scaled)
return model, scaler
|
交互式参数选择 (Marimo UI)
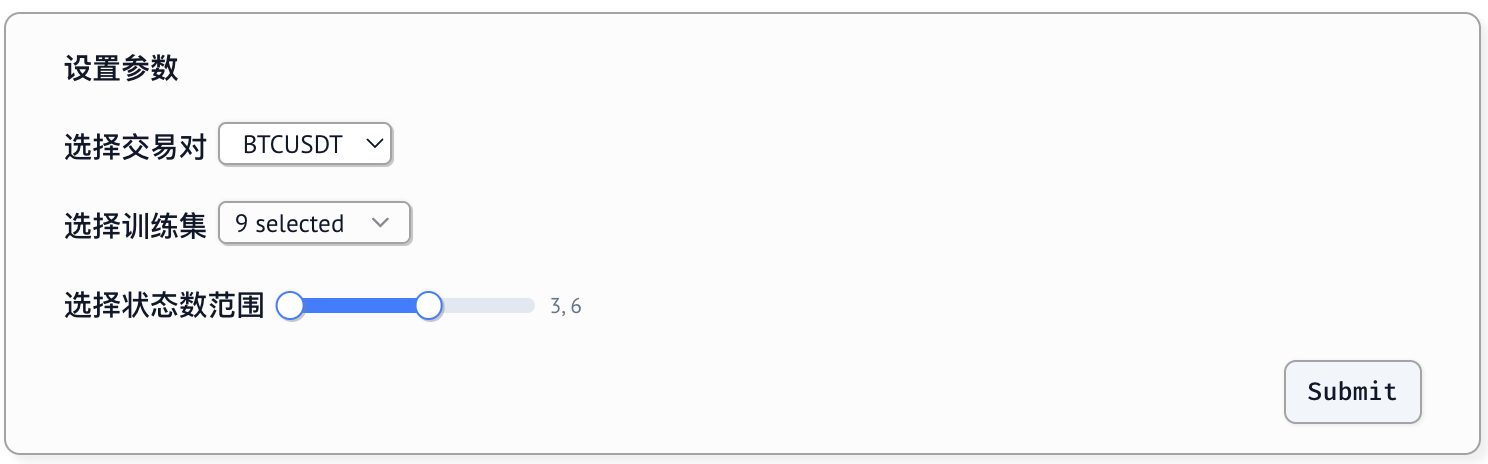
我们通过交互式界面设置实验参数。我们关注的状态数范围设定为3到6,因为市场至少应包含“上涨、下跌、震荡”三个状态,而过多的状态数(超过6个)通常难以进行有效的金融解读。
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
| form = (
mo.md("""
**设置参数**
{asset_selector}
{wfo_nums_selector}
{states_slider}
""")
.batch(
asset_selector=mo.ui.dropdown(
options=["BTCUSDT"], value="BTCUSDT", label="选择交易对"
),
wfo_nums_selector=mo.ui.multiselect(
options=list(range(1, 10)),
value=[1, 3, 5, 7, 9],
label="选择训练集",
),
states_slider=mo.ui.range_slider(
start=3,
stop=8,
step=1,
value=[3, 6],
show_value=True,
label="选择状态数范围",
),
)
.form()
)
form
|
第二部分:BIC计算与稳定性分析
根据参数设置,我们选择了5个WFO训练集(1, 3, 5, 7, 9)和状态数范围[3, 6]进行实验。
BIC计算过程
执行逻辑: 代码遍历选定的WFO周期和状态数范围,针对每个组合加载数据,标准化,训练HMM模型,并记录计算出的BIC值。
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
| mo.stop(not form.value)
# 获取参数
asset = form.value["asset_selector"]
wfo_nums = sorted(form.value["wfo_nums_selector"])
states_range = form.value["states_slider"]
states = list(range(states_range[0], states_range[1] + 1))
# 记录BIC
bic = {}
# 对每一轮训练集,尝试不同的状态数量,记录每个状态对应的AIC和BIC
total_iterations = len(wfo_nums) * len(states)
with mo.status.progress_bar(
total=total_iterations, title="Train HMM models"
) as bar:
for wfo_num in wfo_nums:
file_path = data_dir / f"{asset}_train_{wfo_num}.csv"
features = pd.read_csv(file_path, index_col="date", parse_dates=True)
bic[wfo_num] = {}
for state in states:
bar.update(increment=1, subtitle=f"WFO={wfo_num} States={state}")
try:
model, scaler = train_hmm(features, states=state)
features_scaled = scaler.transform(features)
model_bic = model.bic(features_scaled)
except Exception as e:
print(e)
else:
bic[wfo_num].update({state: model_bic})
|
BIC结果表格与百分比变化
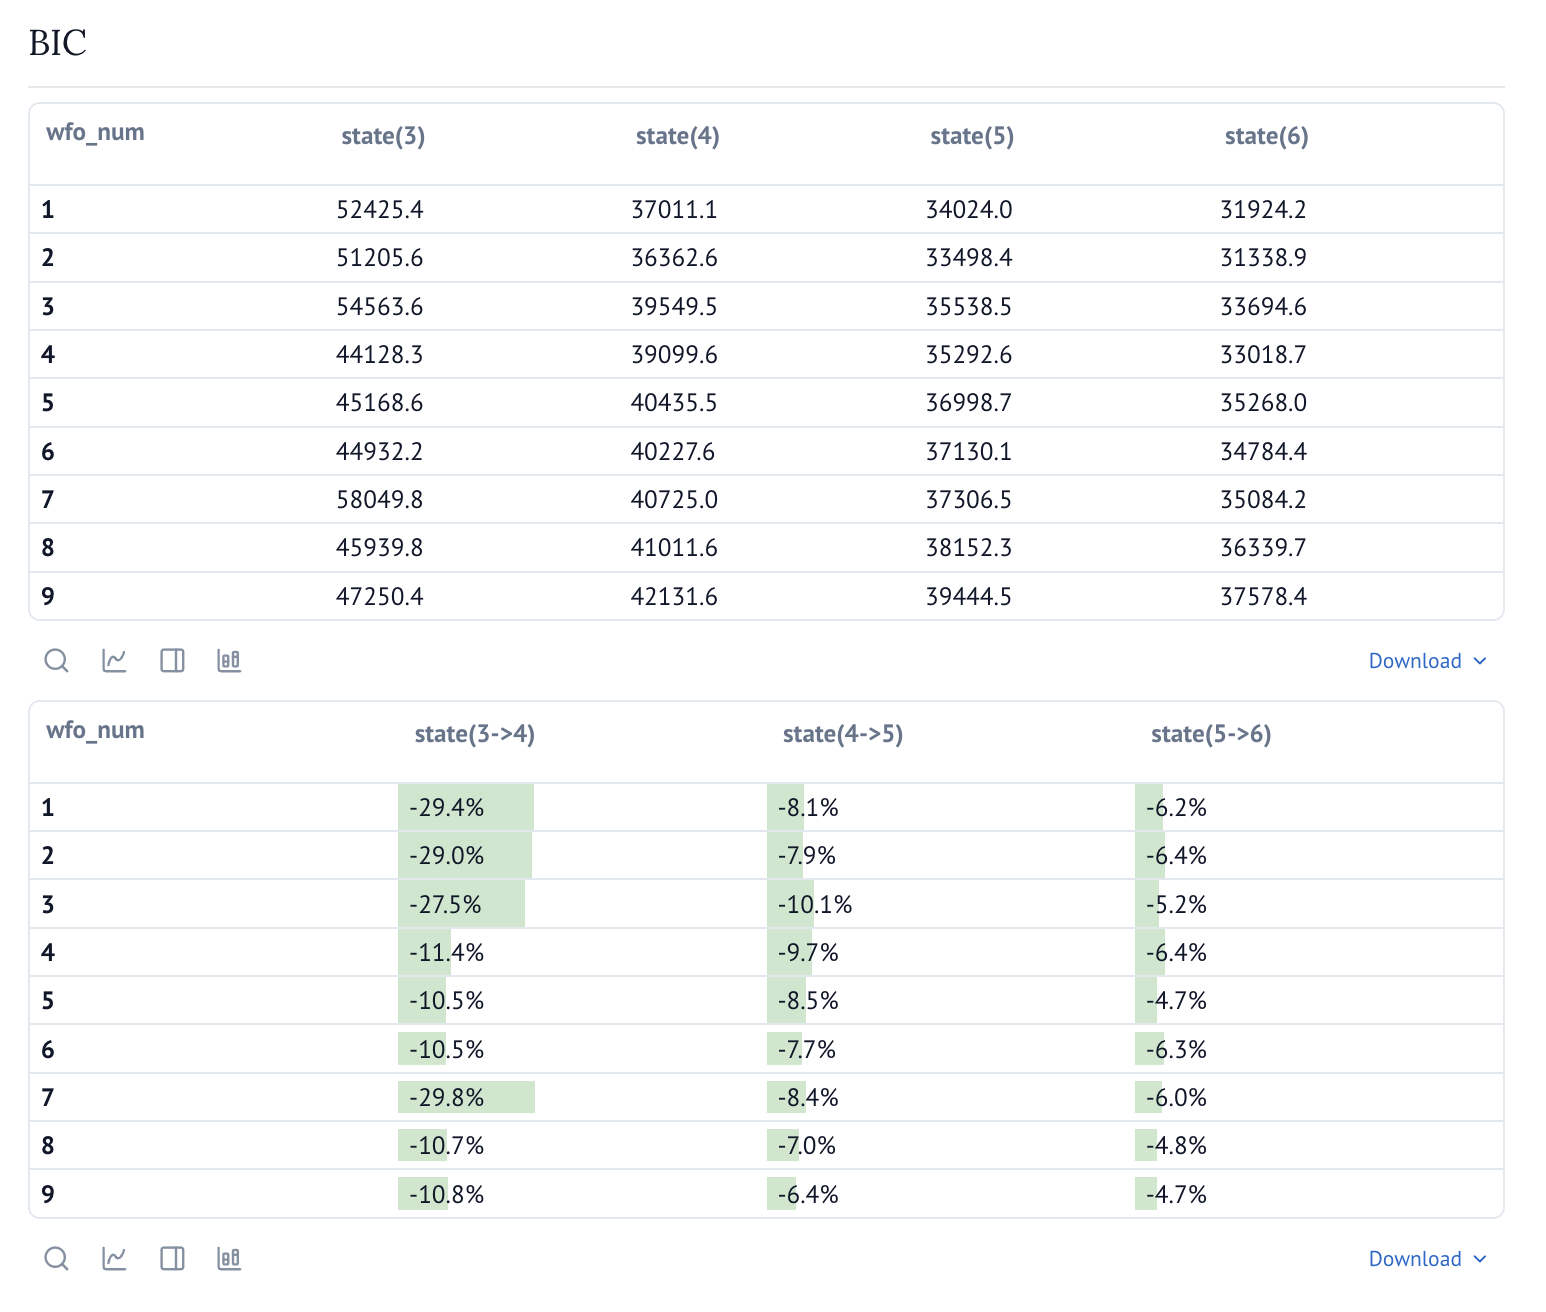
以下表格展示了不同WFO周期(训练集)和不同状态数下的BIC绝对值,以及状态数增加时BIC的百分比变化(即模型改进的边际增益)。
解读BIC变化: BIC值是负数。在统计学上,我们追求BIC的绝对值最大(即越接近0),或者说,随着模型复杂度的增加,BIC的减少速度越慢越好,但这里的hmmlearn返回的可能是负对数似然值相关的值,我们关注的是相对变化和绝对值的大小。在我们的表格中,绿色的柱状条表示BIC下降(模型拟合度提升),红色表示上升(模型拟合度变差)。我们寻找的是BIC持续下降,但下降速度开始减缓的最佳点。
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
| mo.stop(not form.value)
# 创建表格显示BIC
bic_df = pd.DataFrame(bic).T
bic_df.index.name = "wfo_num"
bic_df.columns = [f"state({col})" for col in bic_df.columns]
bic_table = mo.ui.table(
bic_df,
show_column_summaries=False,
show_data_types=False,
selection=None,
format_mapping={col: "{:.1f}" for col in bic_df.columns},
)
# 创建表格显示BIC的变化
bic_chg_df = bic_df.pct_change(axis=1).dropna(axis=1)
bic_chg_df.columns = [
f"state({states[i - 1]}->{states[i]})" for i in range(1, len(states))
]
def style_cell(_rowId, _columnName, value):
# 计算柱状条的宽度(基于绝对值的百分比)
# 假设最大变化为80%,用于标准化柱状条长度
max_change = 0.8
bar_width = min(abs(value) / max_change * 100, 100)
# 根据正负值选择颜色
if value < 0:
bar_color = (
"rgba(76, 175, 80, 0.3)" # 绿色(负值表示BIC下降,模型改进)
)
else:
bar_color = (
"rgba(244, 67, 54, 0.3)" # 红色(正值表示BIC上升,模型变差)
)
style = {
"background": f"linear-gradient(to right, {bar_color} {bar_width}%, transparent {bar_width}%)",
"backgroundSize": "100% 70%", # 柱状条高度为单元格的70%
"backgroundPosition": "center", # 垂直居中
"backgroundRepeat": "no-repeat",
}
return style
bic_chg_table = mo.ui.table(
bic_chg_df,
show_column_summaries=False,
show_data_types=False,
selection=None,
format_mapping={col: "{:.1%}" for col in bic_chg_df.columns},
style_cell=style_cell,
)
mo.vstack([mo.md("### BIC"), mo.md("---"), bic_table, bic_chg_table])
|
第三部分:实证分析与最终决定
结果洞察
绝对最小值: 从BIC绝对值(第一张表)来看,在所有选定的训练集(WFO 1, 3, 5, 7, 9)中,状态数=6时的BIC值都是最低的。这表明,从纯粹的拟合度角度,6个隐状态能最好地解释当前数据的复杂性。
边际增益递减: 观察BIC百分比变化表(第二张表):
- 状态从 3 -> 4 时,BIC有显著的大幅下降(平均约-29%)。
- 状态从 4 -> 5 时,BIC继续下降,但降幅减缓(平均约-15%)。
- 状态从 5 -> 6 时,BIC依然下降,但降幅进一步显著递减(平均约-5%)。
结论:平衡拟合度与可解释性
根据奥卡姆剃刀原理(Ockham’s Razor)和BIC对复杂度的惩罚机制,我们需要在模型的拟合优度和解释性之间找到平衡点。
- 状态数=6 提供了最佳的拟合度,但在金融应用中,6个市场状态可能过于复杂,难以清晰地赋予经济学意义(例如,如何区分“弱上涨”和“中度上涨”?)。
- 状态数=5 在拟合度和复杂度之间取得了较好的权衡。虽然 BIC 相比状态 6 略高,但其增加状态数带来的边际增益(从4到5)仍相对可观。在实践中,5个状态(如:强上涨、弱上涨、震荡、弱下跌、强下跌)通常具有良好的可解释性。
最终决策: 综合考量拟合度、稳定性和可解释性,我们认为状态数=5是一个更稳健的选择。虽然状态数=6的BIC最低,但状态数=5的增益衰减已表明模型复杂度开始接近瓶颈,继续增加状态数带来的边际改进已不值得我们承担更高的过拟合和解释难度风险。
后续步骤
接下来,我们将使用确定的5个隐状态,拟合HMM的最终模型。在下一部分中,我们将分析这5个隐状态的统计特性(均值、方差等),赋予它们明确的市场结构意义,并最终将其应用于样本外数据的市场结构预测。
 量化炼金