使用隐马尔可夫模型(HMM)识别市场结构:第二部分
 量化炼金
在前一部分,我们利用Zorro平台计算并导出了HMM模型所需的五种关键特征,完成了滚动窗口优化(WFO)下的数据划分。
模型的稳健性不仅依赖于特征的有效性,还取决于训练数据和测试数据分布的一致性,即特征的“时间稳定性”。如果模型在训练集上学习到的特征统计特性与测试集(样本外数据)显著不同,那么模型的泛化能力将大打折扣。
本文将使用Python Marimo Notebook,对导出的特征数据进行深度可视化分析。核心目标:对比每个特征在训练集和测试集上的统计分布,以验证我们在第一部分中选取的特征是否具备良好的时间稳定性。
特征回顾
用于构建HMM模型的5个特征。
| 特征名称 | HMM中的作用与区分度 |
|---|---|
| 对数收益率 (Log Return) | HMM的基石观测值。不同市场状态(隐状态)下,该特征的统计分布(如均值、方差)有显著差异。例如,上涨状态对应正均值,下跌状态对应负均值,震荡状态对应零均值。模型通过学习这些分布来定义和区分状态。 |
| 上涨概率 (Rising Probability) | 一个强大且经过平滑的趋势方向指标。它为HMM提供了区分“上涨状态”和“下跌状态”的清晰、低噪音信号。该特征值接近1时,极大概率对应上涨状态;接近0时,对应下跌状态;在0.5附近徘徊则可能对应震荡状态。 |
| ATR比率 (ATR Ratio) | 区分市场“性格”的核心特征,尤其能解决策略在“宽幅震荡”中失效的痛点。HMM可以学习到:低ATR比率对应“窄幅震荡/盘整”状态,而高ATR比率对应“宽幅震荡”状态。它是定义状态波动性特征的关键。 |
| 费舍尔转换 (Fisher Transform) | 捕捉价格行为的**“持续性”与“往复性”**。在趋势状态下,该指标倾向于长时间停留在上下轨,表现出行为的“持续性”。在震荡状态下,它会频繁地在上下轨之间摆动并穿越零轴,表现出行为的“往复性”。这个动态行为模式为HMM区分“趋势”和“震荡”提供了独特的视角。 |
| 价格偏离趋势线的百分比 (Deviation) | 衡量动能。当价格过度偏离趋势线时,通常意味着上涨/下跌动能开始达到顶峰,但趋势可能延续,直到动能出现明显的衰竭迹象。 |
Marimo notebook
| |
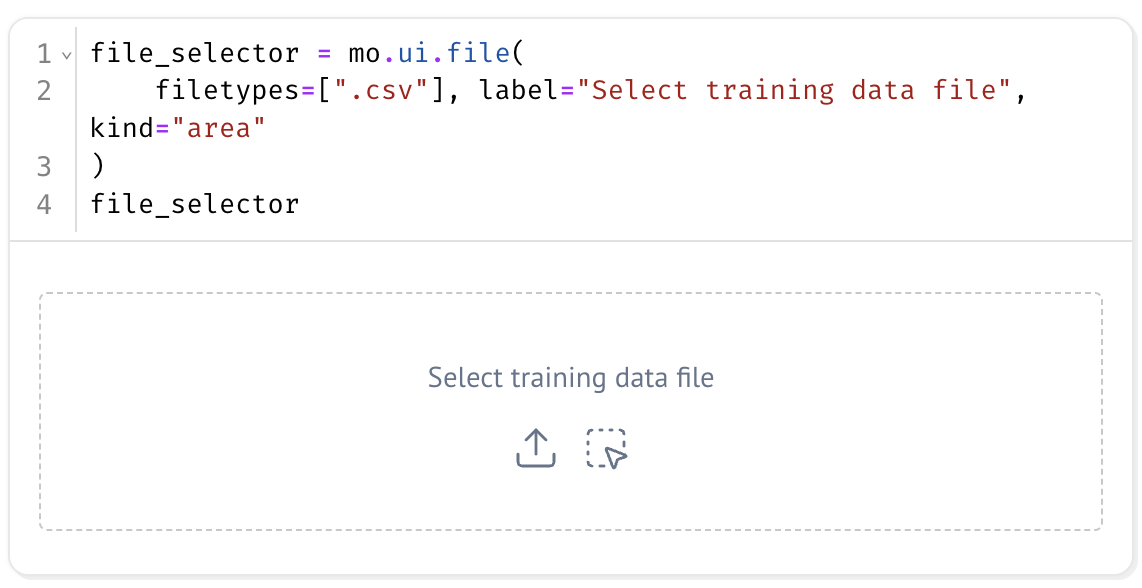
首先,我们需要一个机制来加载Zorro导出的数据文件,这里使用Marimo的文件选择器。
| |
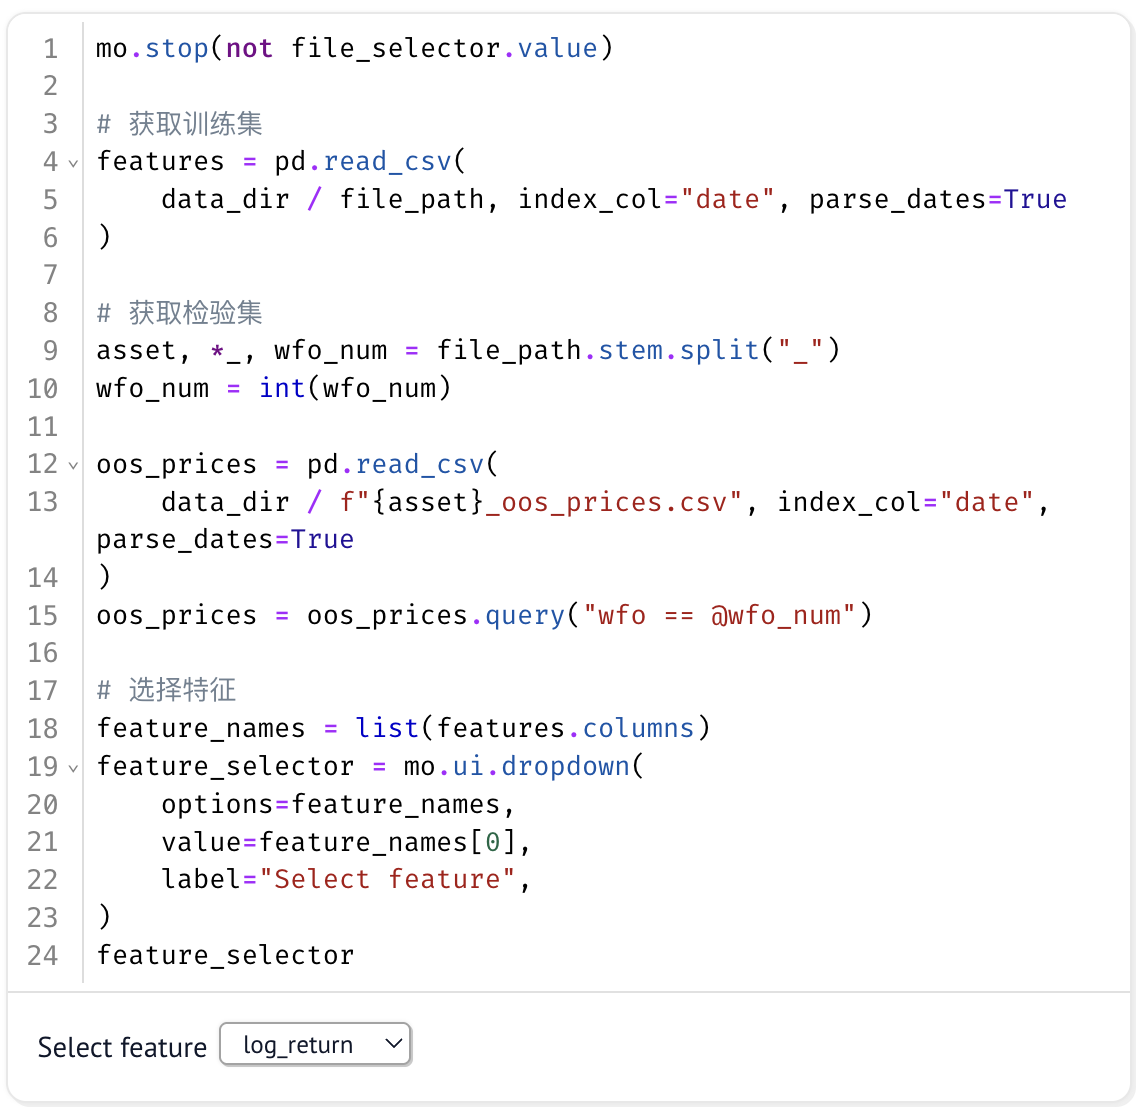
其次,我们需要一个下拉菜单来循环检查每个特征。
特征分析
验证特征稳定性的最佳方法是:
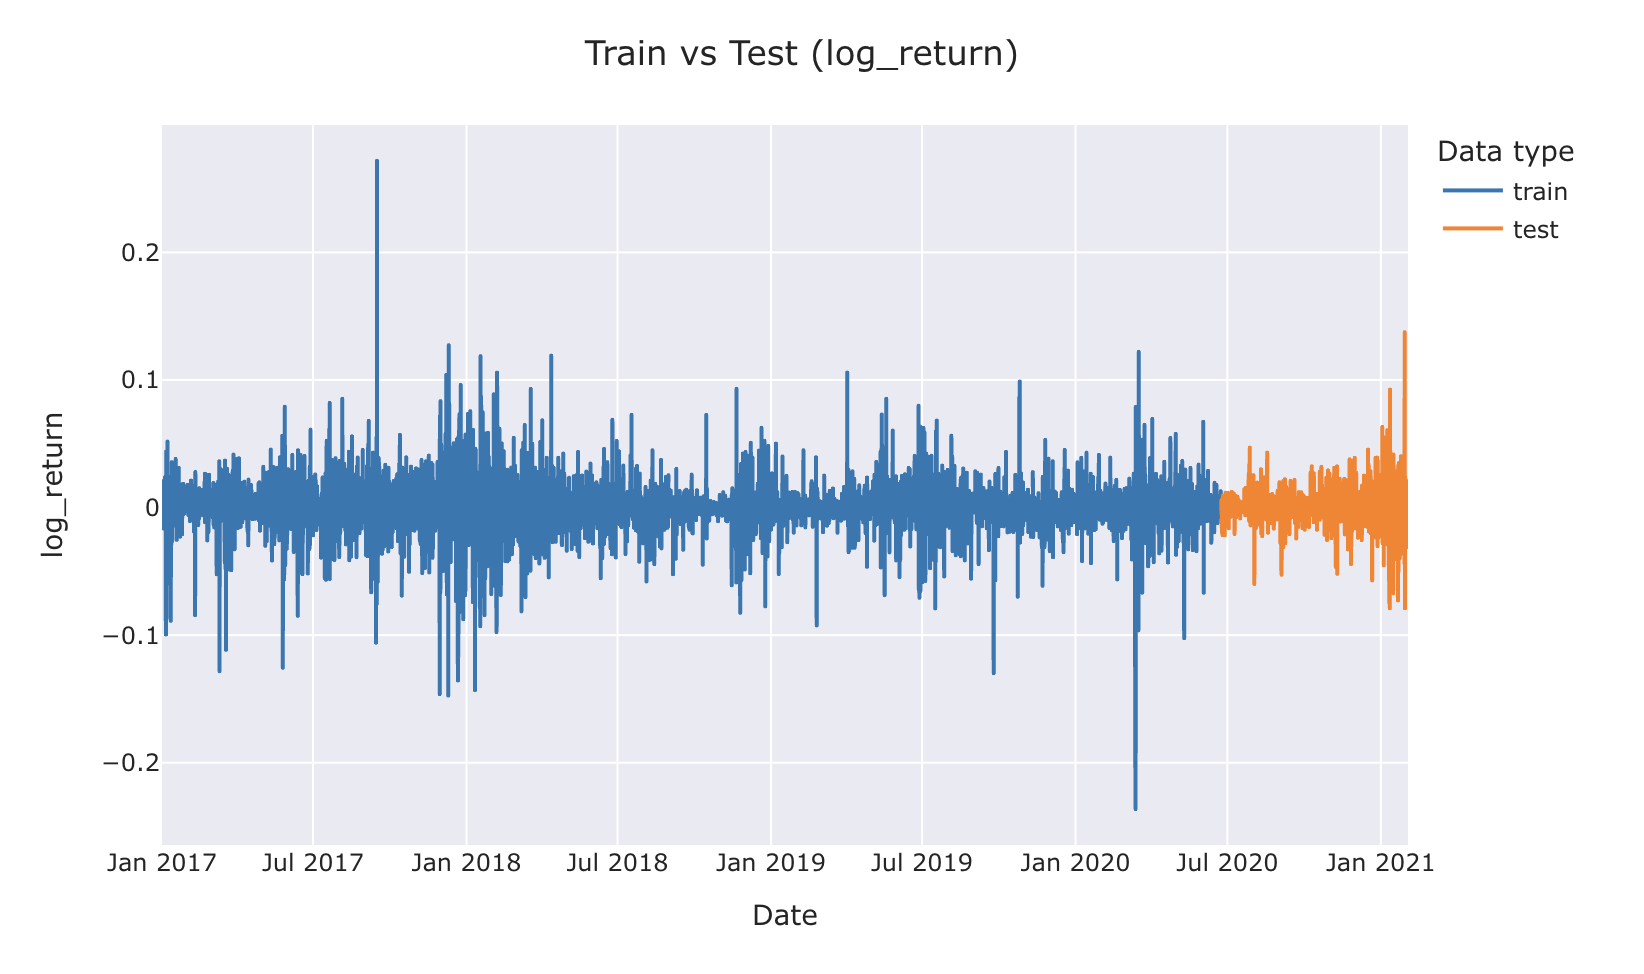
- 时序图对比: 观察训练集和测试集的数据在时间轴上的变化趋势是否连贯。
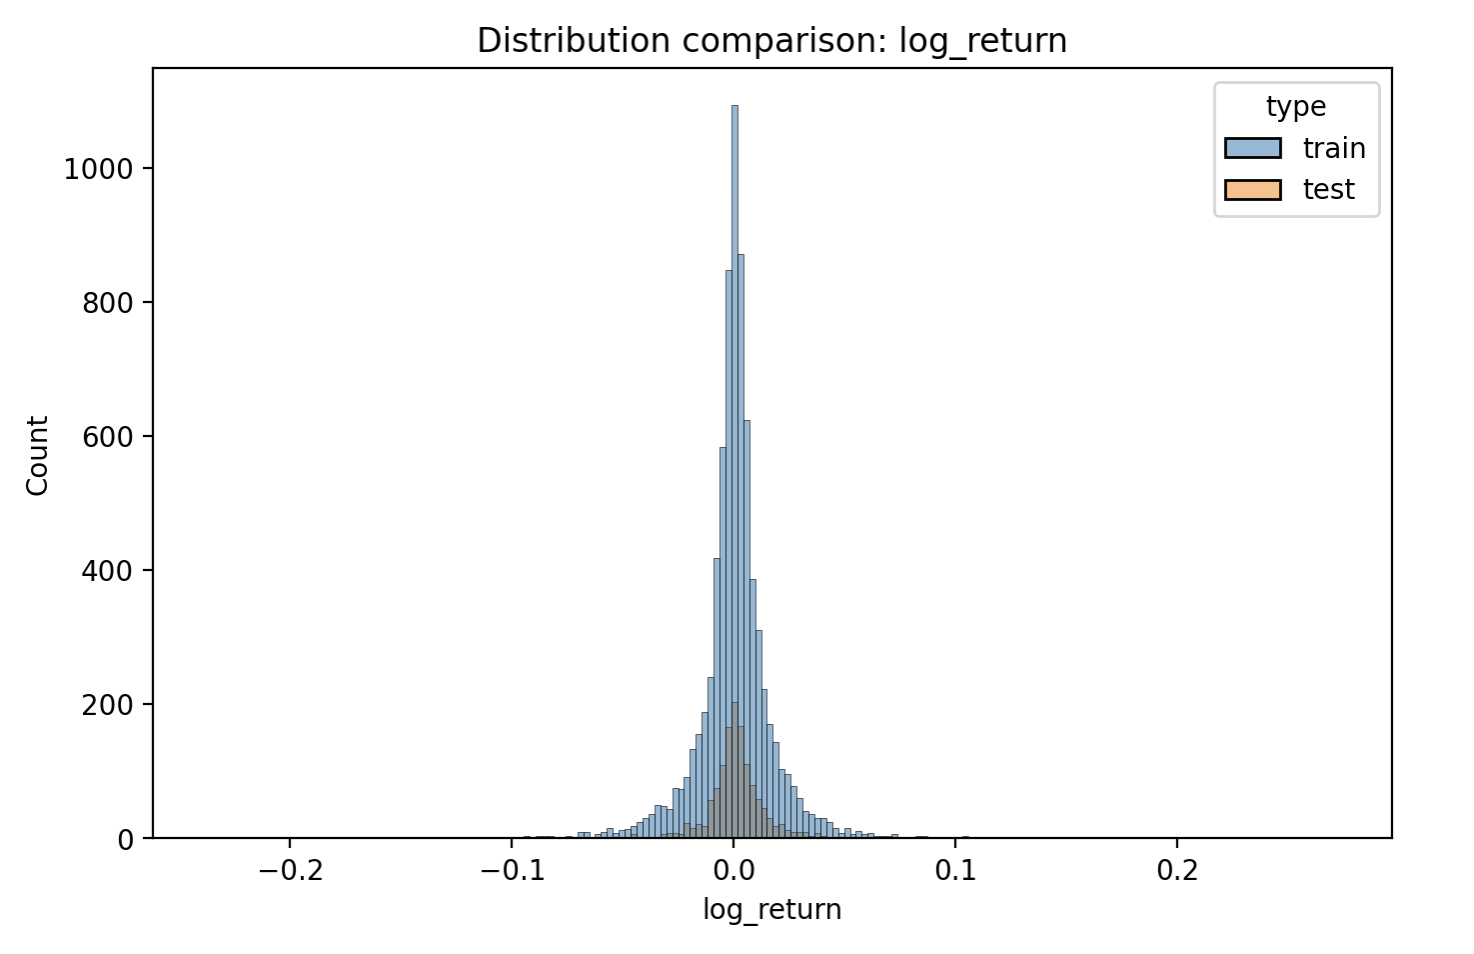
- 直方图对比: 检验两个集合的统计分布(均值、方差、偏度、峰度)是否接近。
1. 时序图:训练集 vs 测试集
选择一个特征,将训练集和测试集的数据连接起来,并用不同的颜色区分它们,观察走势。
| |
2. 直方图检验分布
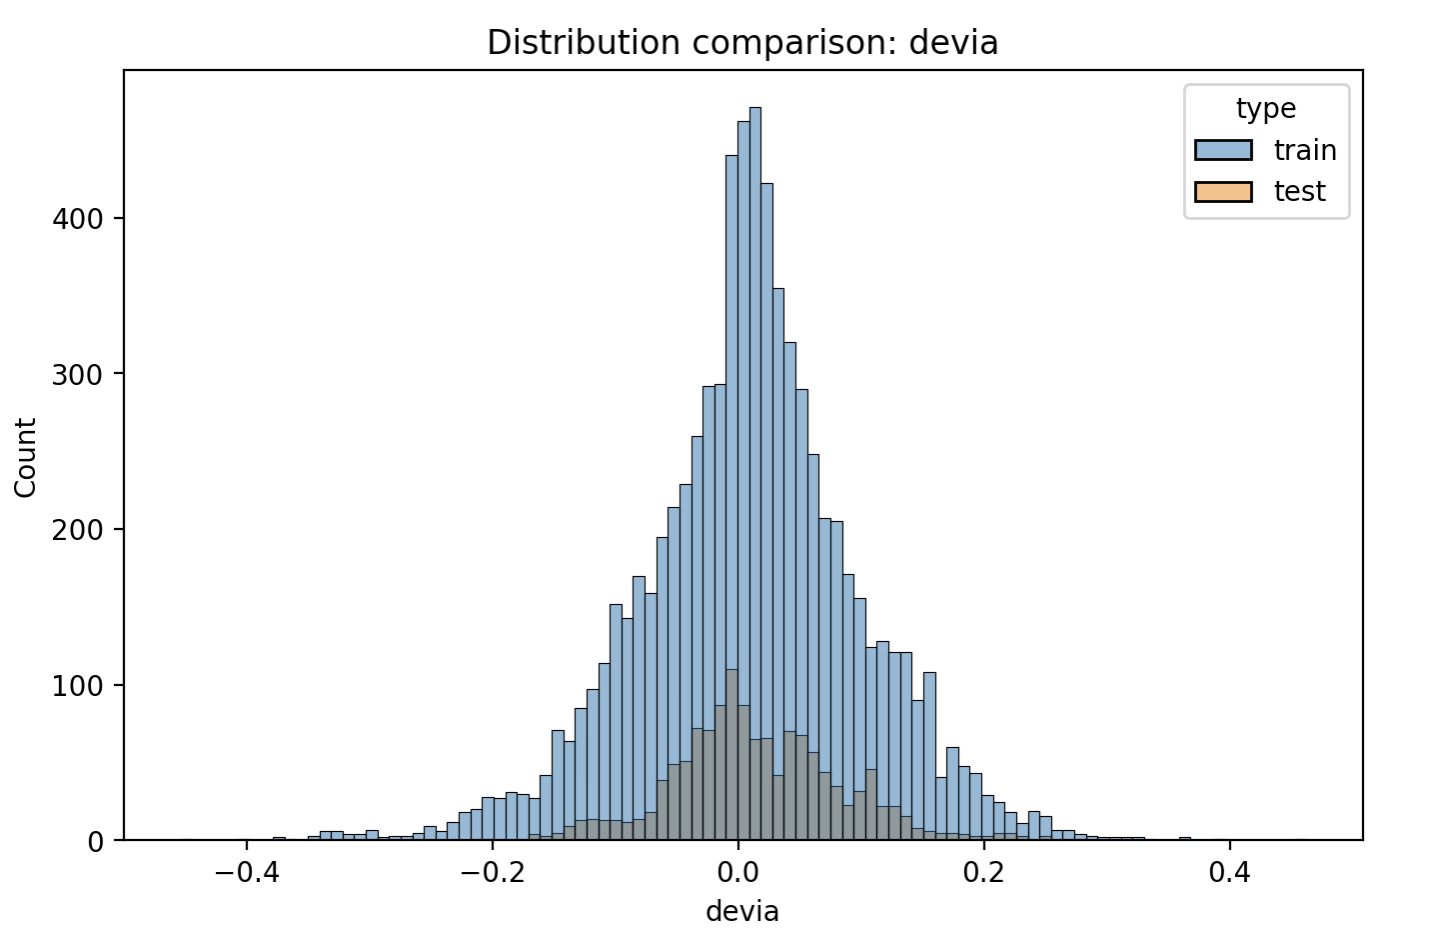
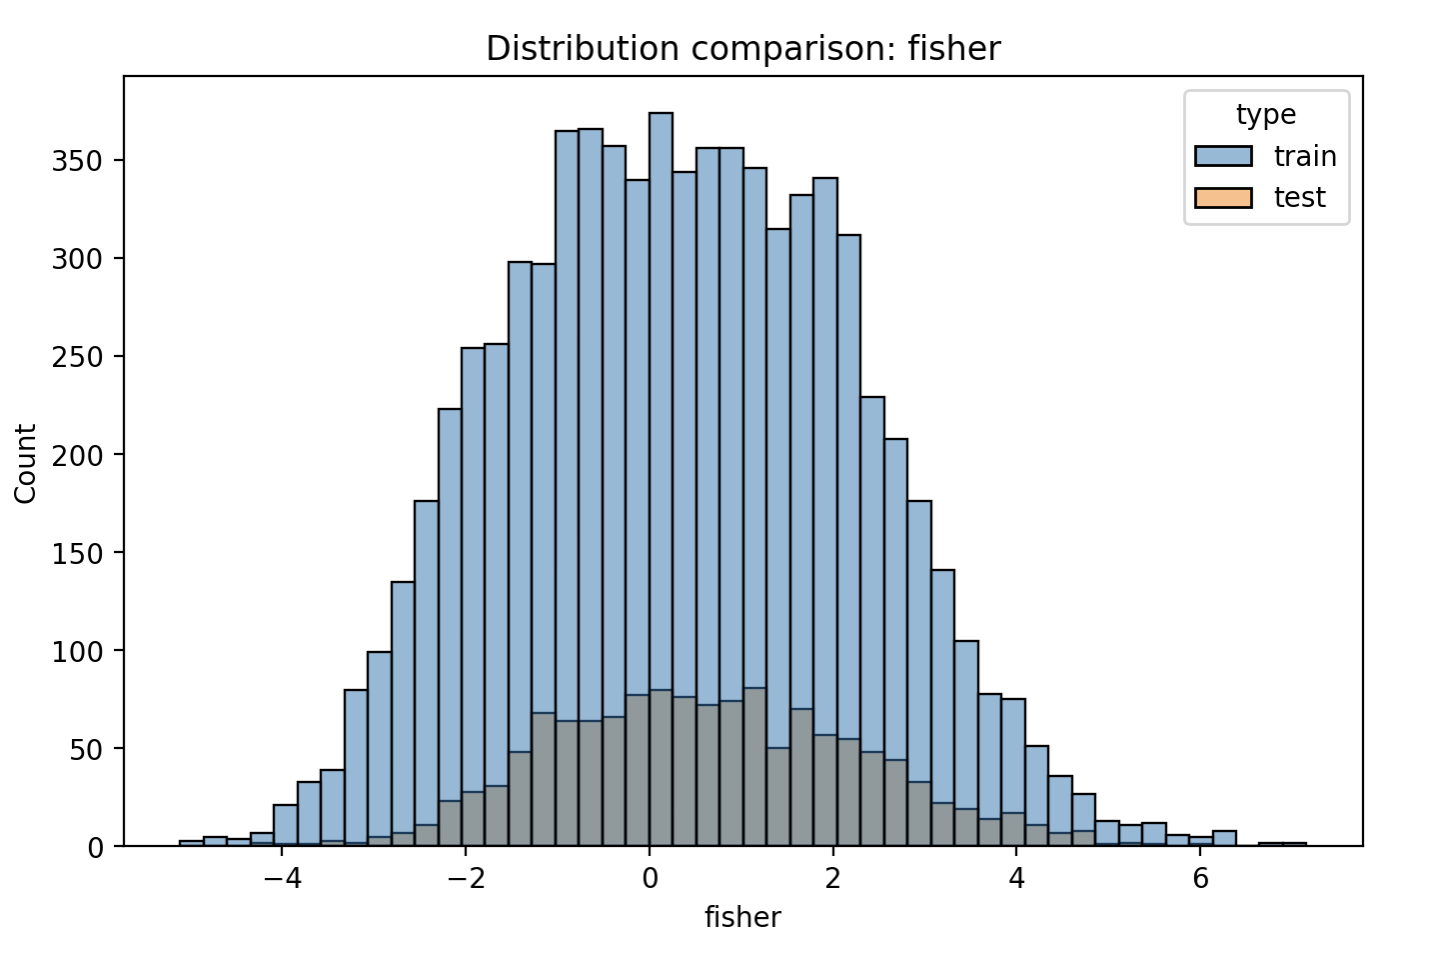
比时序图更重要的是统计分布的一致性。如果训练集上的分布形状(如偏度和峰度)与测试集相似,则模型学习到的模式在样本外数据中更有可能复现。
| |
分析结论
- 分布相似性高:所有特征在训练集和测试集上的分布形状和范围都表现出高度的相似性。这有力地证明了这些特征具备相对良好的时间稳定性。
- 分布类型差异:
- 近似正态分布的特征:对数收益率、费舍尔转换和价格偏离趋势线的百分比,它们的分布形态大致呈钟形,中心对称。
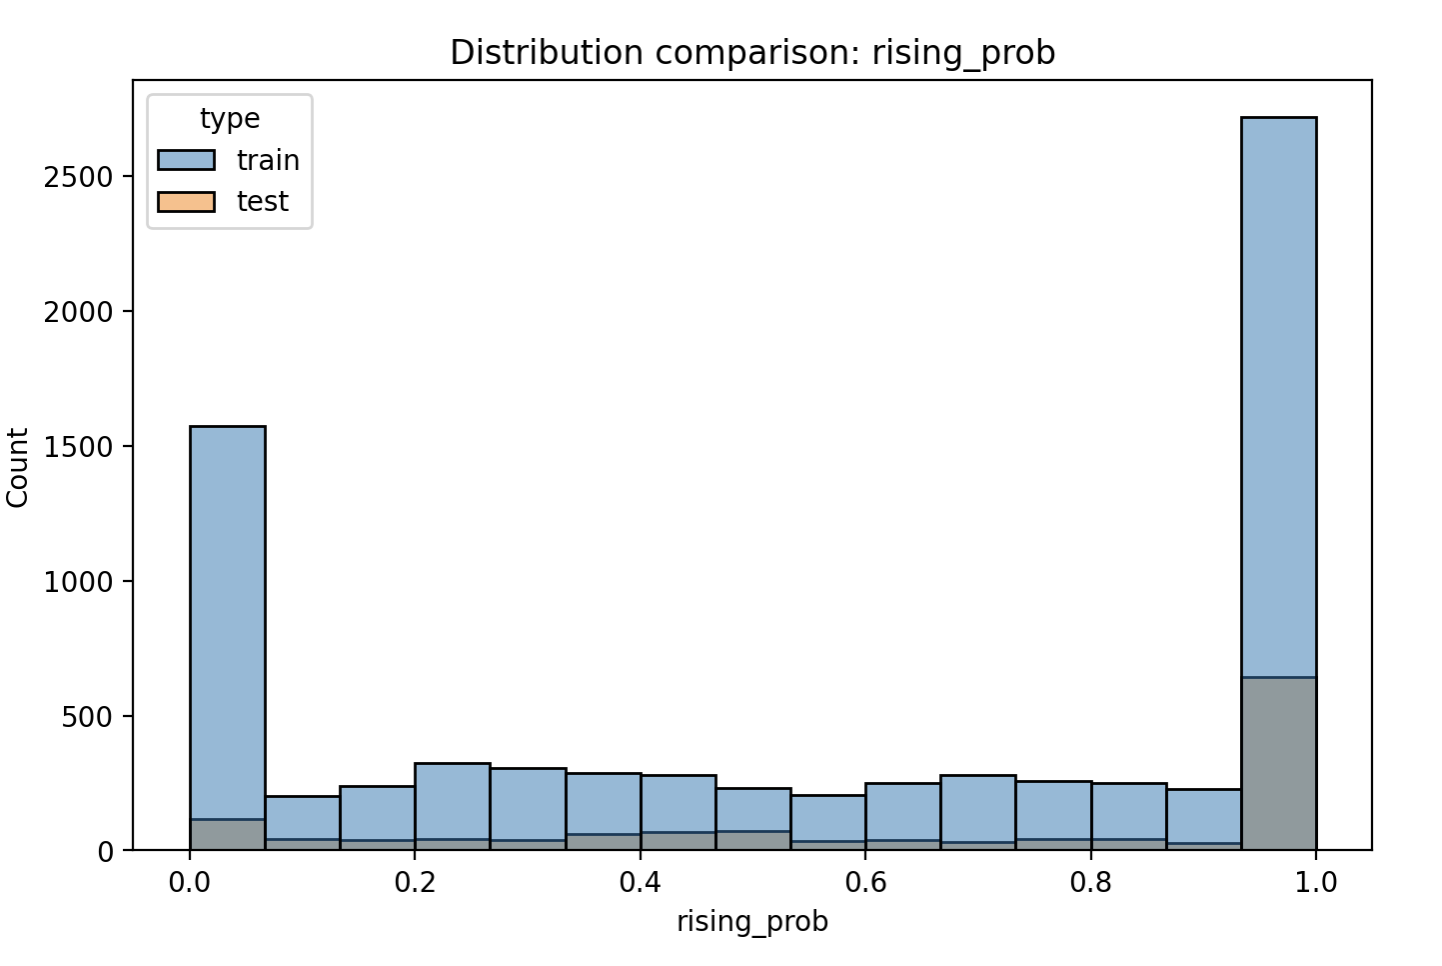
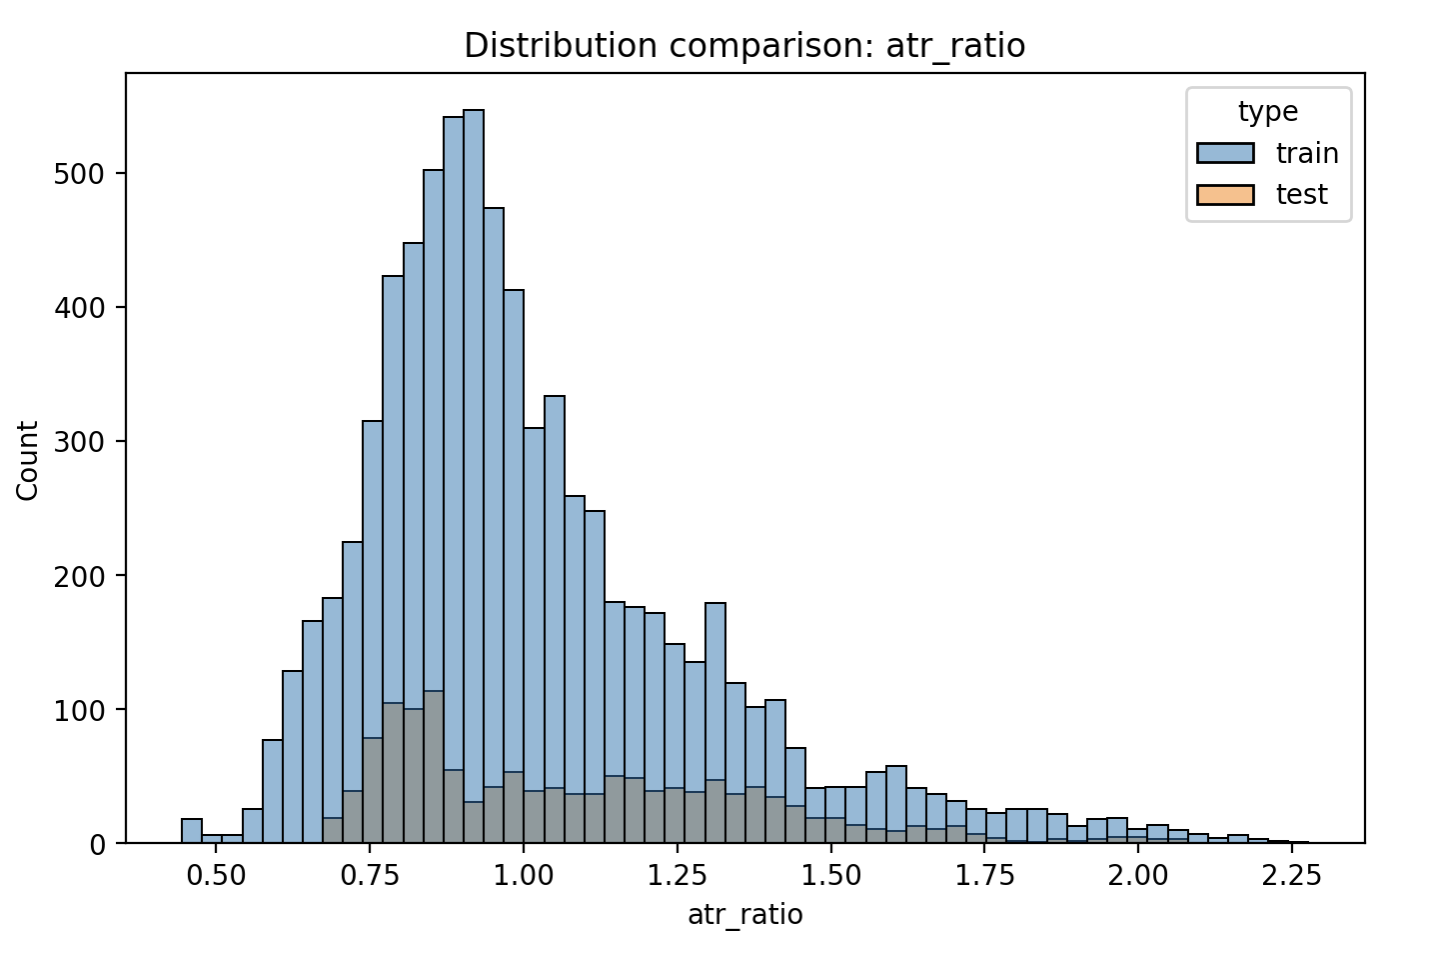
- 非正态分布的特征:上涨概率和ATR比率的分布明显不服从正态分布。例如,上涨概率的分布偏向于两端(0或1),ATR比率则可能偏向某一侧。
HMM是一种基于隐状态的混合模型。它最大的优势之一是不依赖于输入特征服从正态分布的假设,也不要求特征是平稳的。对于非正态分布的特征(如ATR比率,它提供了一种波动率的相对量度),HMM可以通过学习每个隐状态下观测值的实际分布,来准确捕捉其统计特性。
因此无论特征是否服从正态分布,都已通过了分布稳定性检验,可以作为HMM模型的输入。
特征分布图例(训练集1)
训练集1 - 上涨概率分布 (Rising Probability):
训练集1 - ATR比率分布 (ATR Ratio):
训练集1 - 费舍尔转换指标分布 (Fisher Transform):
训练集1 - 价格偏离趋势线的百分比分布 (Deviation):