使用隐马尔可夫模型(HMM)识别市场结构:第一部分
目录

为何需要HMM识别市场“隐藏”状态?

传统的量化策略往往基于单一的市场模式假设,在面对多变的行情(趋势、震荡、宽幅波动)时表现不佳。隐马尔可夫模型(HMM)提供了一个优雅的解决方案:它假设资产价格存在多种不可见的“隐藏”状态(如上涨、下跌、震荡),并能根据可观察的特征数据,输出当前市场处于每种状态的概率。

本系列研究旨在利用HMM的“诊断现在”能力,指导交易决策。这篇文章是整个工作流的第一步:特征选择与数据管道构建。我们将使用Zorro平台作为计算引擎,计算一系列经过精心挑选的预测特征,并将其导出到csv,为后续在Python中进行HMM模型训练做好准备。

研究流程

  1. Zorro计算特征:选择、计算特征指标,并导出到CSV文件。
  2. Python构建HMM:基于特征数据训练HMM模型,生成样本外(Out-of-Sample)的状态预测概率,并再次导出到csv。
  3. Zorro回测检验:将HMM的预测结果导入Zorro,进行最终的回溯检验,评估模型在真实交易环境中的有效性。

本文将重点聚焦于步骤1:特征选择的逻辑与Zorro的数据导出实现。

特征选择

HMM的核心在于,它通过观察一系列可观测特征的统计分布变化,来推断背后的隐藏市场状态。因此,选择具有区分度和稳定性的特征至关重要。

我们选择的特征必须能够清晰地描绘出市场在趋势方向、动能和波动性上的差异。下表详细解释了每个特征在HMM模型中的角色和价值。

特征名称HMM中的作用与区分度
对数收益率 (Log Return)HMM的基石观测值。不同市场状态(隐状态)下,该特征的统计分布(如均值、方差)有显著差异。例如,上涨状态对应正均值,下跌状态对应负均值,震荡状态对应零均值。模型通过学习这些分布来定义和区分状态。
上涨概率 (Rising Probability)一个强大且经过平滑的趋势方向指标。它为HMM提供了区分“上涨状态”和“下跌状态”的清晰、低噪音信号。该特征值接近1时,极大概率对应上涨状态;接近0时,对应下跌状态;在0.5附近徘徊则可能对应震荡状态。
ATR比率 (ATR Ratio)区分市场“性格”的核心特征,尤其能解决策略在“宽幅震荡”中失效的痛点。HMM可以学习到:低ATR比率对应“窄幅震荡/盘整”状态,而高ATR比率对应“宽幅震荡”状态。它是定义状态波动性特征的关键。
费舍尔转换 (Fisher Transform)捕捉价格行为的**“持续性”与“往复性”**。在趋势状态下,该指标倾向于长时间停留在上下轨,表现出行为的“持续性”。在震荡状态下,它会频繁地在上下轨之间摆动并穿越零轴,表现出行为的“往复性”。这个动态行为模式为HMM区分“趋势”和“震荡”提供了独特的视角。
价格偏离趋势线的百分比 (Deviation)衡量动能。当价格过度偏离趋势线时,通常意味着上涨/下跌动能开始达到顶峰。这个特征帮助HMM识别潜在的回调压力或趋势的延续性。

HMM的优势:无需平稳性检验 不同于许多时间序列模型,HMM并不要求输入特征是平稳的(Stationary)。这意味着我们可以直接使用原始特征,无需进行复杂的差分操作。HMM的强大之处在于,它能自主地从非平稳数据中识别出潜在的、具有统计一致性的“隐状态”。

💡 特征的分布稳定性

选择特征时必需考虑训练集和检验集的分布是否相似。如果特征的分布在不同的市场阶段发生显著变化(即非时间稳定),会导致模型性能严重恶化。

例如,如果某个波动性指标(如ATR)的取值范围在训练集是100-1000,但在测试集变为1000-5000,模型在训练集学到的模式在测试集将毫无用武之地,进而做出完全错误的决策。因此,我们优先考虑“标准化”或“归一化”后的指标,以确保其取值范围和分布在不同的时间段内保持相对相似。

Zorro 实现

我们使用Zorro来计算上述特征,并采用**滚动窗口优化(Walk Forward Optimization, WFO)**的方法,将数据划分为多轮训练集和测试集,以模拟真实的交易环境。

回测环境设置:

  • 资产: BTCUSDT
  • K线周期: 四小时图
  • 样本: 2017年至2025年
  • WFO: 10轮滚动训练,训练集比例为85%
  1
  2
  3
  4
  5
  6
  7
  8
  9
 10
 11
 12
 13
 14
 15
 16
 17
 18
 19
 20
 21
 22
 23
 24
 25
 26
 27
 28
 29
 30
 31
 32
 33
 34
 35
 36
 37
 38
 39
 40
 41
 42
 43
 44
 45
 46
 47
 48
 49
 50
 51
 52
 53
 54
 55
 56
 57
 58
 59
 60
 61
 62
 63
 64
 65
 66
 67
 68
 69
 70
 71
 72
 73
 74
 75
 76
 77
 78
 79
 80
 81
 82
 83
 84
 85
 86
 87
 88
 89
 90
 91
 92
 93
 94
 95
 96
 97
 98
 99
100
101
102
103
104
105
106
107
108
109
110
111
112
113
114
115
116
117
118
119
120
121
122
123
124
125
126
127
128
129
130
131
132
133
134
135
136
137
138
139
140
141
142
143
144
145
146
/*
使用 zorro 计算指标并导出到csv,作为 hmm 模型的输入特征。
*/

#include <profile.c>
#include <utils.c>
#include <myindicators.c>

// 参数定义
#define LP_PERIOD 200
#define ATR_FAST 20
#define ATR_SLOW 100
#define FISHER_PERIOD 10

// 使用结构体打包参数
typedef struct {
	var log_ret;
	var rising_prob;
	var atr_ratio;
	var fisher;
	var devia;
	var price;  // 仅用于可视化
	int cycle;  // WFO 周期 id
	string dataset;  // 'TRAIN' or 'TEST'
} HMMFeatures;

// 构建文件路径
string get_csv_path(string asset_name, int cycle, bool is_training) 
{
    if(is_training)
        return strf("Data//%s_train_%d.csv", asset_name, cycle);
    else
        return strf("Data//%s_oos_prices.csv", asset_name);
}

// 输出特征
void export_features(HMMFeatures* f)
{
    bool is_train = (f->dataset == "TRAIN");
    string path = get_csv_path(Asset, f->cycle, is_train);
    
    // 初始化文件头 (仅在第一次运行时)
    if(is(FIRSTRUN)) {
        // 先删除旧文件
        if(file_date(path) > 0)
            file_delete(path);
        
        if(is_train) {
            // 训练集:每个周期单独一个文件,必然覆盖
            file_write(path, "date,log_return,rising_prob,atr_ratio,fisher,devia\n", 0);
        } else {
            // 测试集:是一个累加的大文件。
            file_write(path, "date,log_return,rising_prob,atr_ratio,fisher,devia,price,wfo\n", 0);
        }
    }

    // 正式写入数据行
    // 注意:Zorro 里的 LookBack 期间不应写入数据,否则 Python 处理时会有 NaN 或脏数据
    if(!is(LOOKBACK)) {
        string timestamp = strdate("%Y-%m-%d %H:%M:%S", 0);
        string row;
        
        if(is_train) {
            row = strf("%s,%.6f,%.6f,%.6f,%.6f,%.6f\n", 
                timestamp, f->log_ret, f->rising_prob, f->atr_ratio, f->fisher, f->devia);
        } else {
            row = strf("%s,%.6f,%.6f,%.6f,%.6f,%.6f,%.4f,%d\n", 
                timestamp, f->log_ret, f->rising_prob, f->atr_ratio, f->fisher, f->devia, 
                f->price, f->cycle);
        }
        file_append(path, row, 0);
    }
}

// 计算特征
void calc_features(HMMFeatures* f)
{
    vars Prices = series(price());
    vars Trends = series(LowPass(Prices, LP_PERIOD));
    
    // 1. Log Return
    f->log_ret = log(priceClose(0) / priceClose(1));
    
    // 2. Trend Deviation
    f->devia = (Prices[0] - Trends[0]) / Trends[0];
    
    // 3. Volatility Ratio (短期波动率 / 长期波动率)
    var atr_20 = ATR(ATR_FAST);
    var atr_100 = ATR(ATR_SLOW);
    f->atr_ratio = atr_20 / atr_100;
    
    // 4. Probability (Fuzzy Logic - Rising Probability)
    FuzzyRange = 0.1 * atr_100;
    f->rising_prob = risingF(Trends);
    
    // 5. Fisher Transform
    f->fisher = fisherTransform(Prices, FISHER_PERIOD);
    
    // Meta Data
    f->price = priceC();
    f->cycle = (int)WFOCycle;
}

function run() 
{
	// 日志
	set(LOGFILE);
	
	// 生成 k 线
	resf(BarMode,BR_WEEKEND);
    StartWeek = 0;
    EndWeek = 62359;
    StartMarket = 0;
    EndMarket = 2359;
    BarPeriod = 240; // 四小时图
    BarZone = UTC;
    BarOffset = 0;
    TickFix = 60000;
	
	// WFA 设置
	NumWFOCycles = 10;  // 划分10轮滚动训练集/测试集
	DataSplit = 85;  // 训练集比例为85%
	
	// 回溯设置
	StartDate = 20170101;
	EndDate = 20251230;
	LookBack = 500;
	asset("BTCUSDT");

	//--------------------- 计算指标并导出数据 ---------------------//
	
	// 实例化结构体
	HMMFeatures feat;

	// 计算特征
	calc_features(&feat);

	// 导出逻辑
	if(Train) {
		feat.dataset = "TRAIN";
		export_features(&feat);
	} else if (Test) {
		feat.dataset = "TEST";
		export_features(&feat);
	}
}

生成的多轮滚动数据集

执行上述Zorro脚本后,我们将根据WFO的设置,生成10轮独立的训练集CSV文件,以及一个包含所有样本外数据的测试集文件。
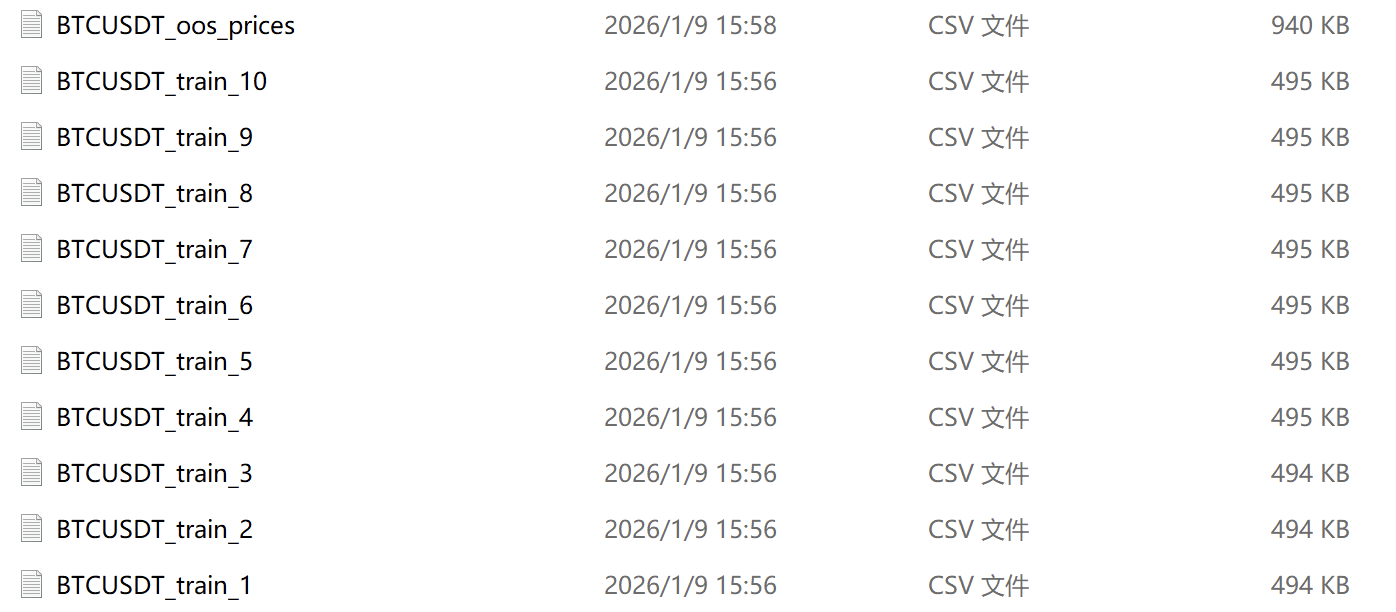
生成数据集